aus dem maschinen- und todo-raum
beim lesen der folgenden artikel fielen mir lauter kleinigkeiten auf, die ich mal wieder aufschreiben wollte.
notiz.blog: Ich hab‘ gerade wieder Spaß…
…an meinem Blog herum zu basteln ♥️!
I keep a list of things I want to do for KDO in Apple Notes, organized into four sections: small, medium, large, and longshots/obsolete.
Ich habe Ferien gemacht und einiges – ich korrigiere: vieles – hier technisch auf Vordermann gebracht.
dieser artikel wiederholt vieles was ich gelegentlich schon mal aufgeschrieben habe und ist eher technisch. also für die meisten hier mitlesenden sicherlich uninteressant. ich habe aber trotzdem das bedürfnis gehabt, das alles mal aufzuschreiben, sozusagen als quartalsweise bestandsaufnahme.
wenns ums machen, konstruieren, herstellen geht ist das wichtigste: gute werkzeuge. aber gute werkzeuge sind wiederum nichts wert, wenn man keinen plan hat, wenn man nicht weiss, was man mit den werkzeugen herstellen oder formen will. und zu wissen, was man machen will ist wiederum wenig wert, wenn man keinen blick fürs grosse und ganze, für den kontext hat.
wenn ich an meiner eigenen webseite rumbastel bin ich bauherr, architekt, fachingenieur, bauleiter und handwerker in personalunion. als bauherr formuliere ich anforderungen und ziele, als architekt entwickle ich das gesamtkonzept, sollte aber immer auch den blick aufs grosse und ganze haben, also die webseite, aber auch den kontext (das web). als architekt und fachingenieur sollte ich wissen was gerade state of the art ist und wie man einerseits erprobte techniken anwendet und trotzdem hier und da innovativ sein könnte. als handwerker sollte ich die geeigneten werkzeuge, liebe zum handwerk und sorgfalt mitbringen.
natürlich muss man das alles nicht in personalunion machen, die klassische arbeitsteilung funktioniert weiterhin. aber mir macht gerade das basteln an meiner website als generalunternehmer spass. oder genauer, der spass, die interessanz, steckt gerade im prozess, in der langfristigen interaktion der verschiedenen rollen. ich als bauherr habe ständig neue ideen und anforderungen an die webseite. ich als architekt erfahre ständig von neuen techniken, neuen materialien, effizienteren verfahren. der fachingenieur in mir sieht neue best practices, neue testverfahren, neue normen, der bauleiter entdeckt immer wieder neue begabte handwerker oder möglichkeiten readymades einzusetzen.
ich verstehe menschen gut, die einfach einen ort zum ablenkungsfreien schreiben haben wollen und sich eigentlich um nichts anderes kümmern wollen. aber mich fasziniert das ständiges rumbasteln und ausloten der möglichkeiten.
mir fallen beim schreiben ständig dinge ein, die ich vielleicht haben können wollte. fussnoten, verknüfpungsmöglichkeiten, die mir ermöglichen dinge besser zu strukturieren oder sinnvoll zu verknüpfen. möglichkeiten das geschriebene auch zu illustrieren oder, je nach kontext, auch mal anders zu gestalten. bei wiederkehrenden problemen fällt mir beim schrieben, nach dem hundersten stolpern, plötzlich eine lösung ein. oft schreibe ich beiträge um ein technisches feature das mich fasziniert auszuprobieren.
eine webseite wie eine wohnung zu beschreiben ist gar nicht so weit weg von der realität. was man sich bei der planung ausdenkt, funktioniert im alltag und im verlauf der zeit nicht immer so, wie man es mal geplant hat oder sich vorgestellt hat. egal wie viele steckdosen man eingeplant hat, am ende sind es immer zu wenige oder sie sind dann doch an den falschen stellen. nutzung verändert die anforderungen. und der luxus darauf ständig reagieren zu können ist (für mich) sehr befriedigend.
die to-do-liste bei kottke hat bei mir mehrere saiten klingen lassen. einerseits weil sich ein paar der ideen von ihm mit meinen decken und andererseits weil er hemmungslos grosse und kleine to-dos auf eine liste setzt. und:
some of the projects and site tweaks I most want to make aren’t even on my list. They live only in my head and I mull them over in the shower or while walking until they’re “done” enough to start working on.
egal wie doll ich versuche strukturiert zu planen und aufzuschreiben was ich mit dieser webseite machen will, ein grossteil der ideen will meinen kopf nicht verlassen bevor sie einen gewissen reifegrad erreicht haben. solange schwirren sie zuverlässig in meinem hinterkopf herum.
im folgenden ein paar der dinge die es im letzten jahr aus meinem kopf auf die webseite geschafft haben. danach ein paar dinge die es aus meinem kopf in eine liste geschafft haben.
syndikation
eine dieser ideen oder eher eine der fragen die jahrelang in meinem kopf herumschwirrte war: wie gehe ich mit instagram um? einerseits find ich meta doof und verstehe instagram nicht mehr wirklich, andererseits gibt es dort immer noch einige leute die sich offensichtlich über fotos von mir freuen und sich dort gerne herumtreiben. aber weil instagram in den letzten jahren alle schotten abgedichtet hat und es unmöglich gemacht hat von dort kopien der eigenen posts für die eigene webseite zu ziehen, wurde das posten dort zu einem mühseligen manuellen prozess. bis mir irgenwann einfiel, dass man dort mit einem „pro“-account auch programatisch posten kann. seitdem schiebe ich instagram-posts einfach von meinem kirby-backend per knopfdruck an, kopiere also von hier nach da. damit bleiben erstmal alle metadaten und originale bei mir. instagram bekommt ne kopie.
genauso mache ich es mit grain, fotos oder foto-serien schiebe ich selektiv von wirres.net zu grain. grain ist übrigens einer der wenigen #ATproto-dienste, die mein interesse seit meiner kurzen euphoriephase halten konnten. den ATproto-standard-reader, in dem ich kurzzeitig einen potenziellen nachfolger des google-readers gesehen habe, finde ich nach wie vor interessant, nutze ihn aber kaum noch. auch weil er (noch) so langsam werkelt, dass es die benutzbarkeit und den bedienungsspass stark einschränkt. aber grain ist toll, so wie früher mal instagram war: leute und deren fotos, umgekehrt chronologisch sortiert. fertig.
mittlerweile bekomme ich teilweise bei grain (17 follower) genauso viele ♥️ wie auf instagram (942 follower). fürs gleiche bild. absurd. daran sieht man wie abgefuckt instagram mittlerweile ist.
nicht sichtbares design
roman jasiek schreibt, dass er sich gerne in viele kleine details reinsteigert, „die vermutlich kaum jemand bewusst wahrnimmt“. das geht mir auch so.

- zum beispiel ziehe ich anführungszeichen in der ersten zeile einer überschrift oder eines absatzes ein stückchen ein, so dass der text sich nach dem text ausrichtet und nicht nach dem satzzeichen. ich gehe davon aus, dass sowas ausser mir niemand sieht. aber mich macht sowas froh.
- oder übergänge beim wechsel/laden von seiten mit den grossartigen view-transitions die mittlerweile von allen browsern unterstützt werden. zum ersten mal beim medienbäcker gesehen und gleich übernommen. mir gehts mittlerweile so, dass die mir nur noch auffallen, wenn ich sie mal ausversehen kaputt mache, weil ich am CSS rumgespielt habe.
![absatz mit vier trennungen und 97 unsichtbaren, bedingten trennzeichen]()
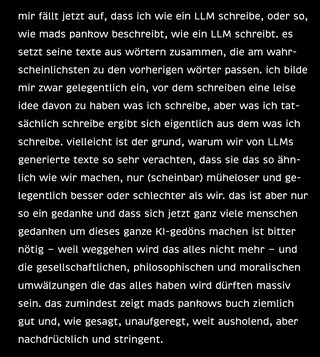
- silbentrennung mit bedingten trennstrichen (soft hyphens). alle texte werden html-seitig bereits mit
­an den stellen die trennbar sind ausgeliefert, so dass browser dann (relativ) zuverlässig den text trennen können. das nervt zwar beim kopieren von text, weil die soft-hyphens mitkopiert werden, aber wer mich unbedingt zitieren oder teile meiner texte kopieren will, kann jederzeit auf die markdow-version wechseln. - oder XLS-dateien, mit denen mal xml-dateien gestalten und strukturiert darstellen kann. das OPML-gedöns, das ich von matthias pfefferle übernommen habe, stylt die OPML-XML-dateien zum beispiel mit so einer XLS-datei (beispiel bei matthias oder hier). diese woche bin ich via kottkes-RSS-feed drauf gekommen, dass man das auch mit RSS (oder atom) machen kann. also hab ichs auch gemcht: /feed oder /feed/bilder. später hab ich gesehen, matthias macht das (natürlich) auch: notiz.blog/feed/. wer das rohe xml sehen will kann immer noch den quellcode ansehen. aber eigentlich sieht das alles eh keiner.
![endmarken bei spiegel.de und wirres.met]()
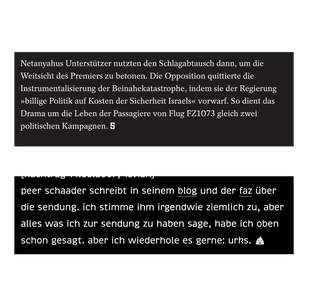
- ein like-button kann auch eine endmarke sein. bis ich drauf gekommen bin, dass ich auch das was der spiegel am ende seiner texte macht auch machen kann, sind ungefähr 12 monate vergangen. jetzt bin sehr zufrieden, dass der „like“ button nicht mehr irgendwo rumhängt, sondern seinen platz am textende hat. unsichtbar ist er zwar nicht, aber so obskur, dass er wohl in 90 prozent der fälle ignoriert wird. und jetzt bekommt man auch eine visuelle belohnung, wenn man drauf klickt.
- ich habe eine rückseite und artikel-beilagen, weil ich die vorderseite möglichst — nun ja — minimalistisch halten will. ich finde seitenleisten und widgets zwar praktisch, aber eigentlich sind sie auch quatsch, weil das web heutzutage vornehmlich mobil stattfindet und da seitenleisten und widgets nicht auf den bildschirm passen auf taschenrechnern ans seitenende rutschen. ich mag die idee ausschliesslich den eigentlichen beitrag zu zeigen, mit den wichtigsten meta-informationen. da wo ich mich durchgerungen habe zusatzinfos auf den vorderseiten anzuzeigen (kommentare, backlinks, reaktionen-zähler), kann man sie auch zuklappen mit dem ▶, bzw. ▼ — was dann auch im browser gespeichert wird.
- auch nicht offensichtlich, also quasi unsichtbar: wenn man auf bilder klickt, geht eine lightbox mit dem bild auf mit der man das bild vergrössern kann, wenn man will. und mit den pfeiltasten (desktop) oder wischend (mobil) kann man dann alle bilder auf der seite durchscrollen, dank prefetching in einem affenzahn. selbst mache ich das gelegentlich sehr gerne auf meiner bilder-übersicht, quasi meinem instagramersatz.
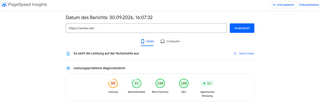
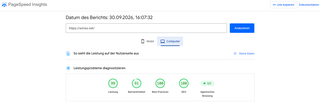
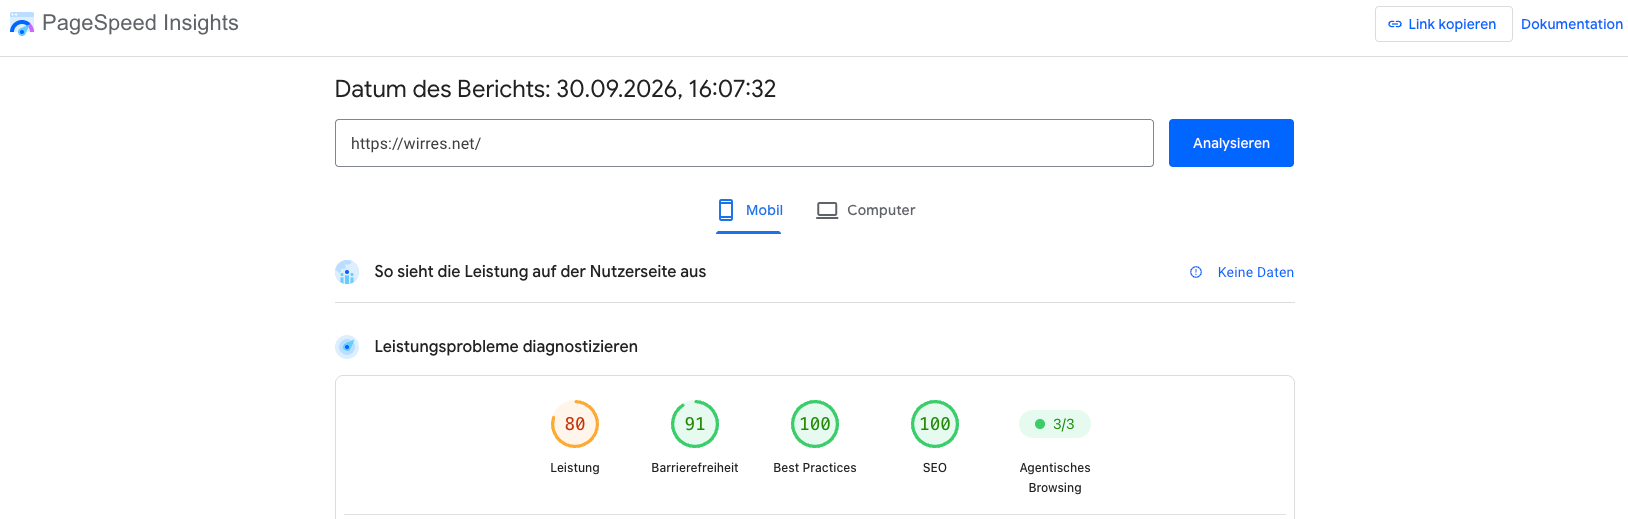
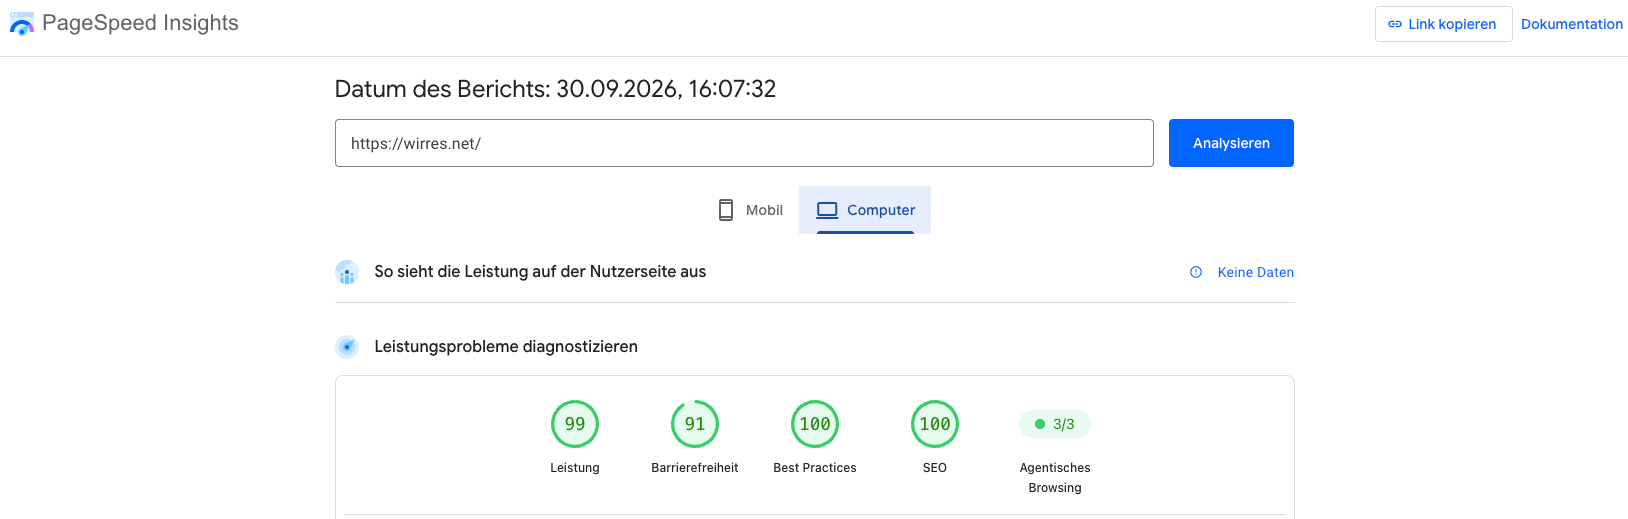
- ladegeschwindigkeit sieht man auch nicht wirklich. was man sieht ist wenn die ladegeschwindigkeit fehlt. auch wenn diese seite nicht besonders schlank ist, fühlt sie sich nach meinem gefühl — in der regel — sehr flüssig an und besteht auch fast alle pagespeed.web.dev-tests. ich möchte auch nicht davon abrücken 21 der neuesten beiträge auf der startseite komplett anzuzeigen, obwohl das natürlich kostet. 4,1 mb wiegt die startseite beim initialen laden. wenn man die startseite bis zum ende durchscrollt, kommen 10 mb zusammen. ein jahr überschriften lädt dagegen nur 203 kb (800 kb unkomprimiert). im hintergrund (unsichtbar) werkeln da lazyloading, src-sets und optimierte bildformate.
![pagespeed-test-ergebnis von wirres.net auf mobil-device; 80% (leistung), 91% (barrierefreiheit), 100% (best practices), 100% (SEO)]()
![pagespeed-test-ergebnis von wirres.net auf desktop-device; 99% (leistung), 91% (barrierefreiheit), 100% (best practices), 100% (SEO)]()
- live fotos sind nicht unsichtbar, aber im besten fall sind sie ein foto mit einer subtilen bewegung, so wie hier zum beispiel. bisher habe ich ive-fotos in einem langen manuellen prozess verarbeitet: airdrop des live fotos auf meinen laptop (kommt als .mov an), ein web-optimiertes .mp4 und poster .jpg mit pixelmator und mediaCMS erstellen, mit einem batch-script ein fallback .gif erstellen und dann diese drei dateien im backend hochladen und konfigurieren. nachdem ich diesen prozess über 12 monate optimiert habe, hab ich mir einen kirby-block schreiben lassen, der das alles automatisiert. jetzt muss ich nur noch den geairdroppten .mov hochladen, den rest erledigt kirby serverseits.
optimierungen
pagespeed.web.dev ist von google, aber trotzdem ein unverzichtbares werkzeug. ein paar optimierungsvorschläge schlage ich konsequent in den wind, deshalb der punktabzug bei der barrierefreiheit und im mobilen bereich. aber wenn ich an der webseite rumfummel, schleichen sich unweigerlich gelegentlich fehler ein. vieles davon entdecke ich dann mit hilfe der PageSpeed Insights. das werkzeug hält mich quasi auf dem stand der aktuellen best practices. die optimierungen die aus solchen besuchen resultieren kommen auch nicht nur google zugute, sondern jedem besuchenden, sei es eine maschine oder ein mensch.
auch das habe ich schon öfter geschrieben, aber es ist und bleibt eins meiner lieblingsthemen: optimierung auf maschinenlesbarkeit. auch hier ist meine motivation nicht primär eine optimierung für google, sondern eben für alle. wer eins meiner rezepte in eine rezeptverwaltung wirft, sollte ein gutes resultat bekommen. wer will kann die rezepte sogar in mela abonnieren. bing, kagi, perplexity können alle auf die strukturierten daten zugreifen die ich hier an meine beiträge hänge. aber soweit ich das mitbekomme, macht derzeit eigentlich nur google davon gebrauch. ich mag was dabei teilweise rauskommt.
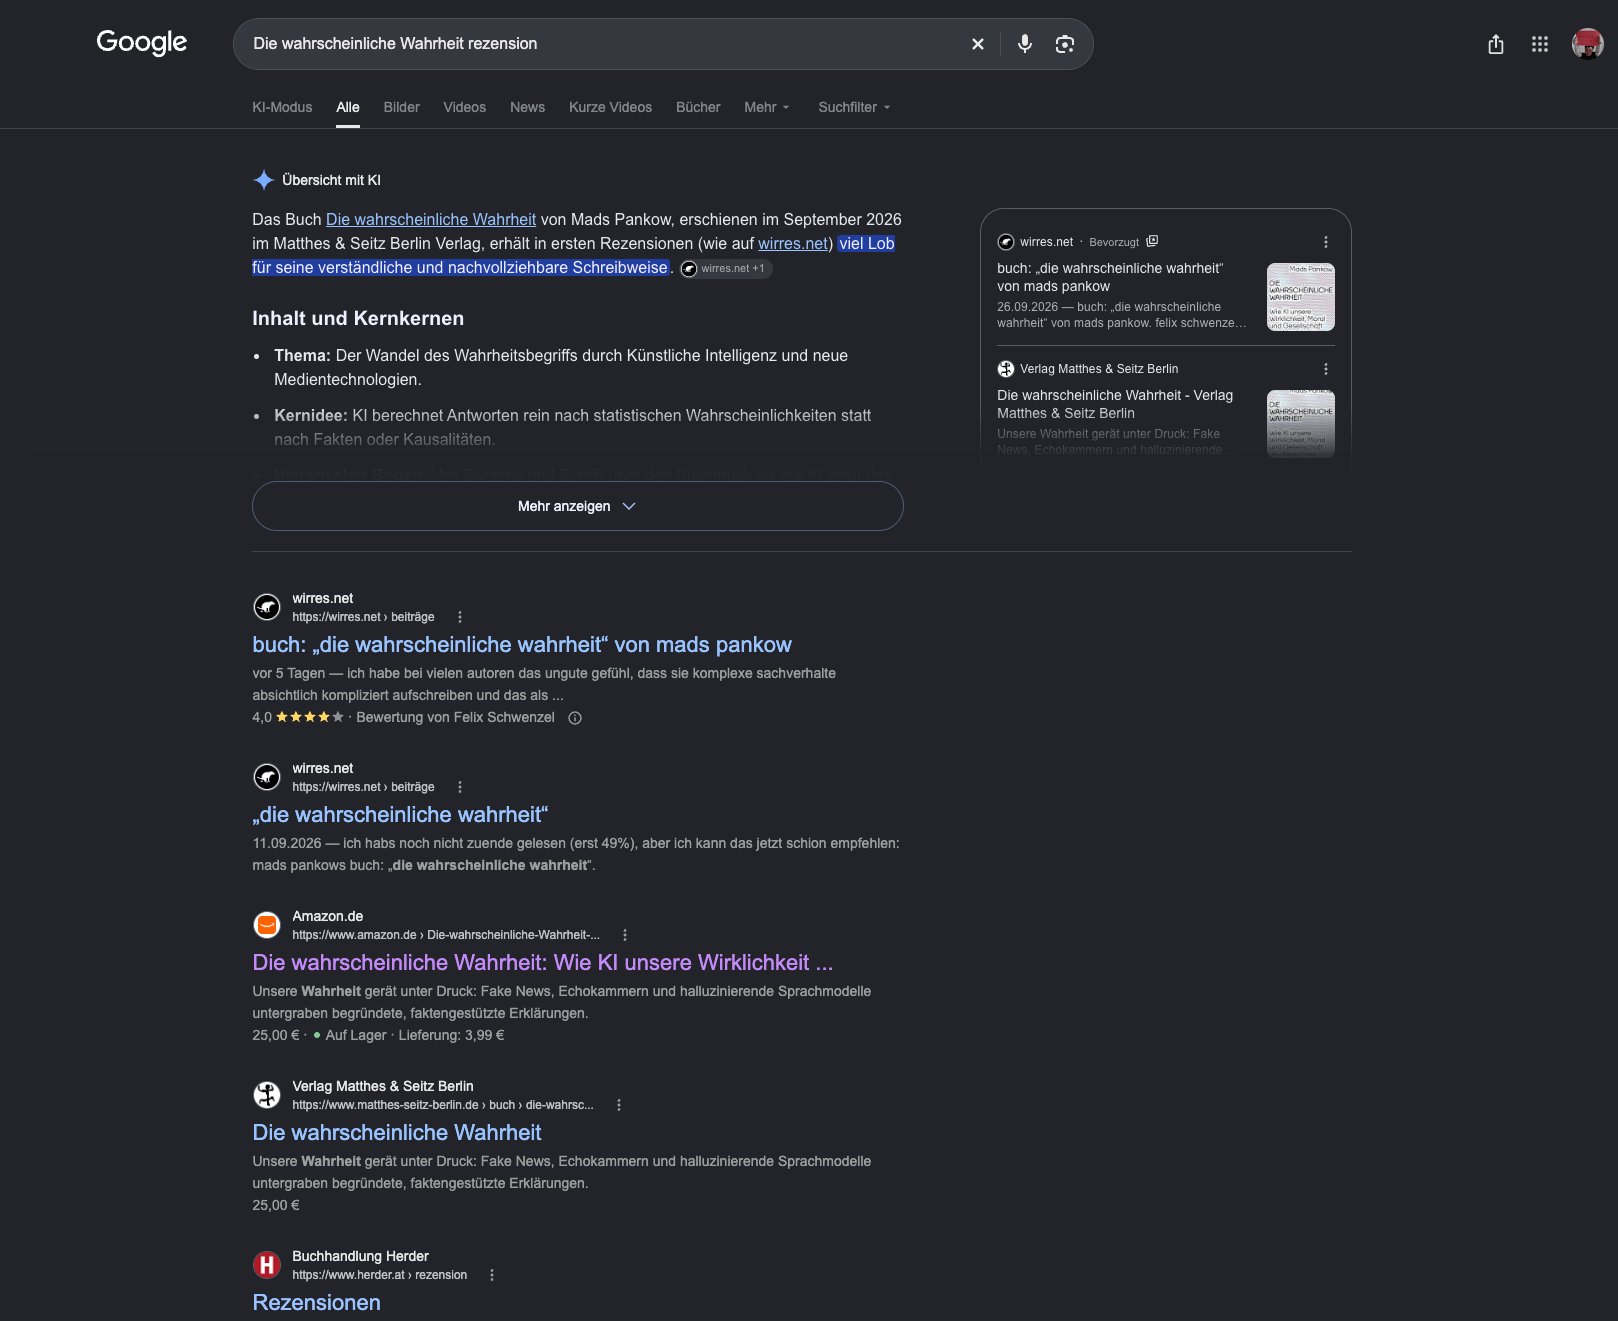
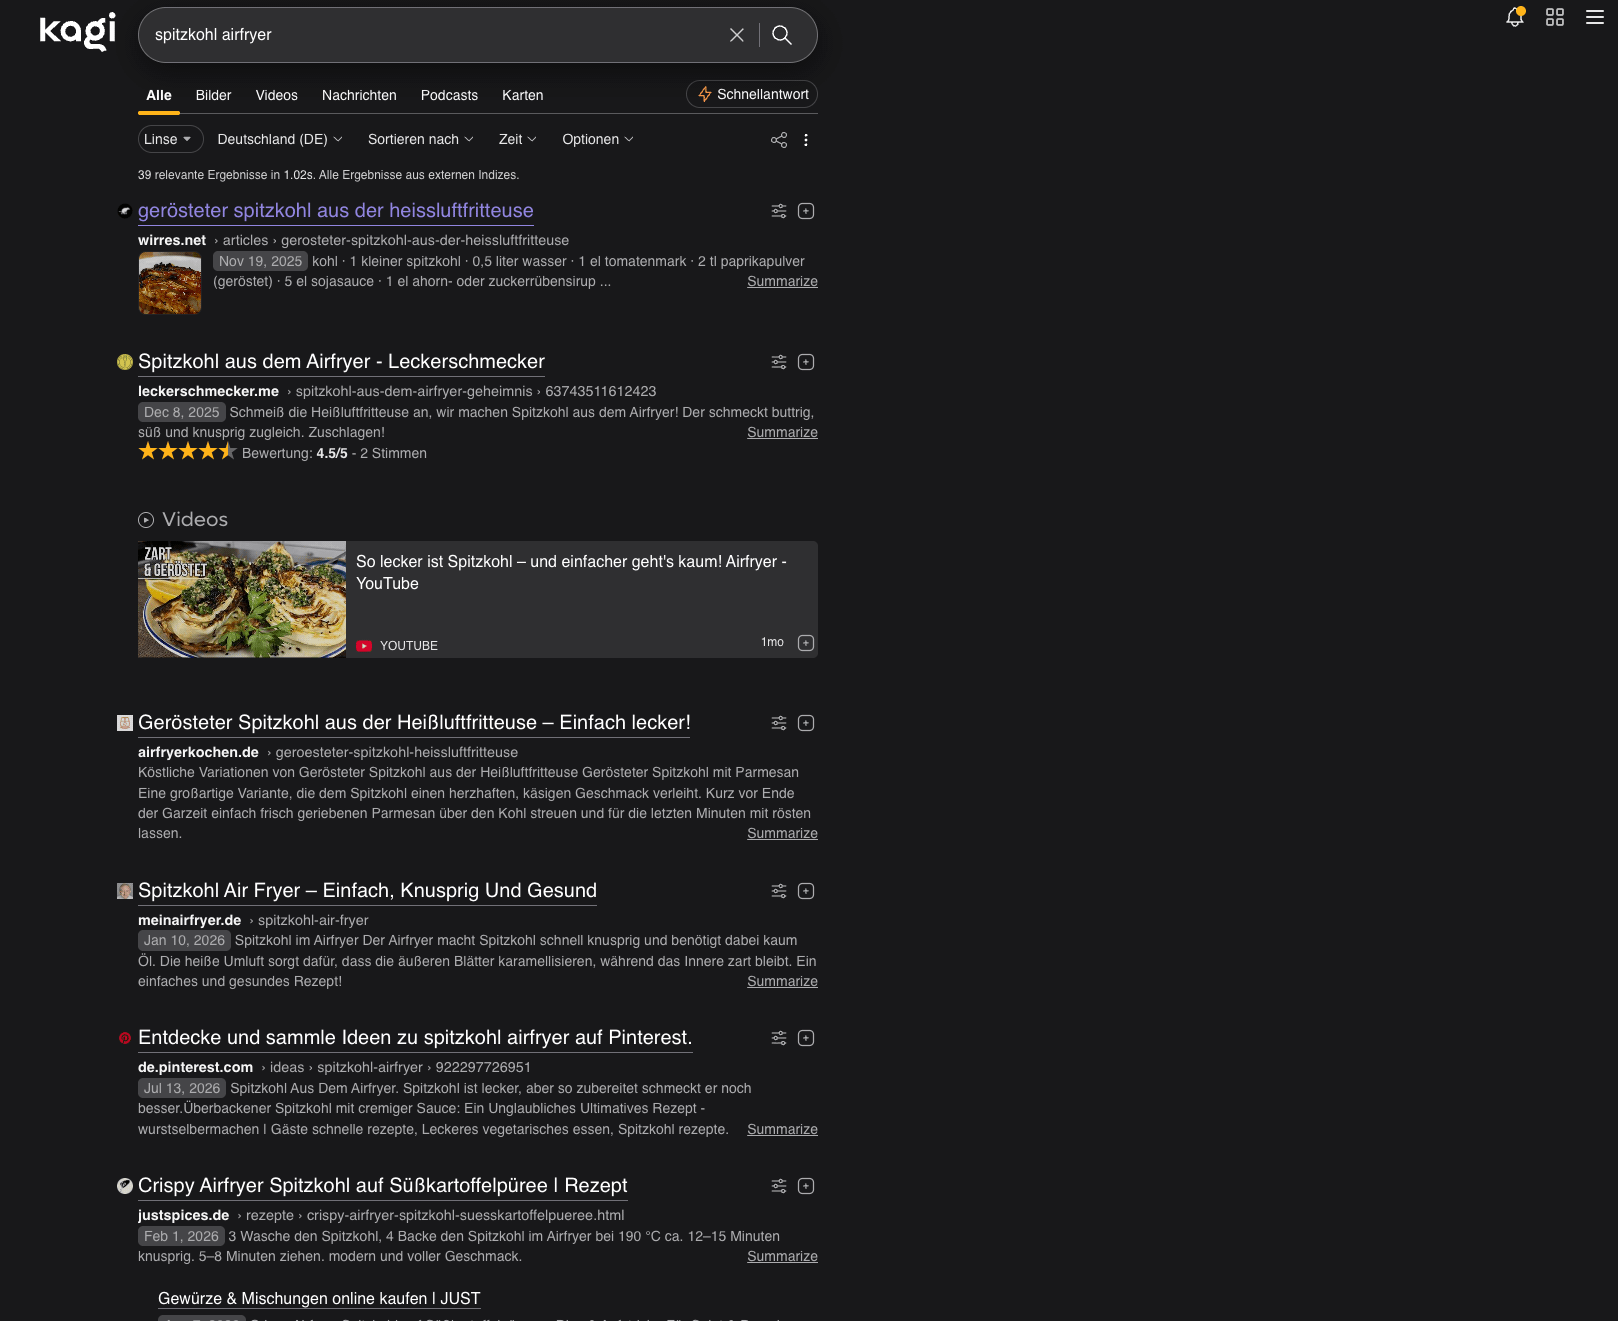
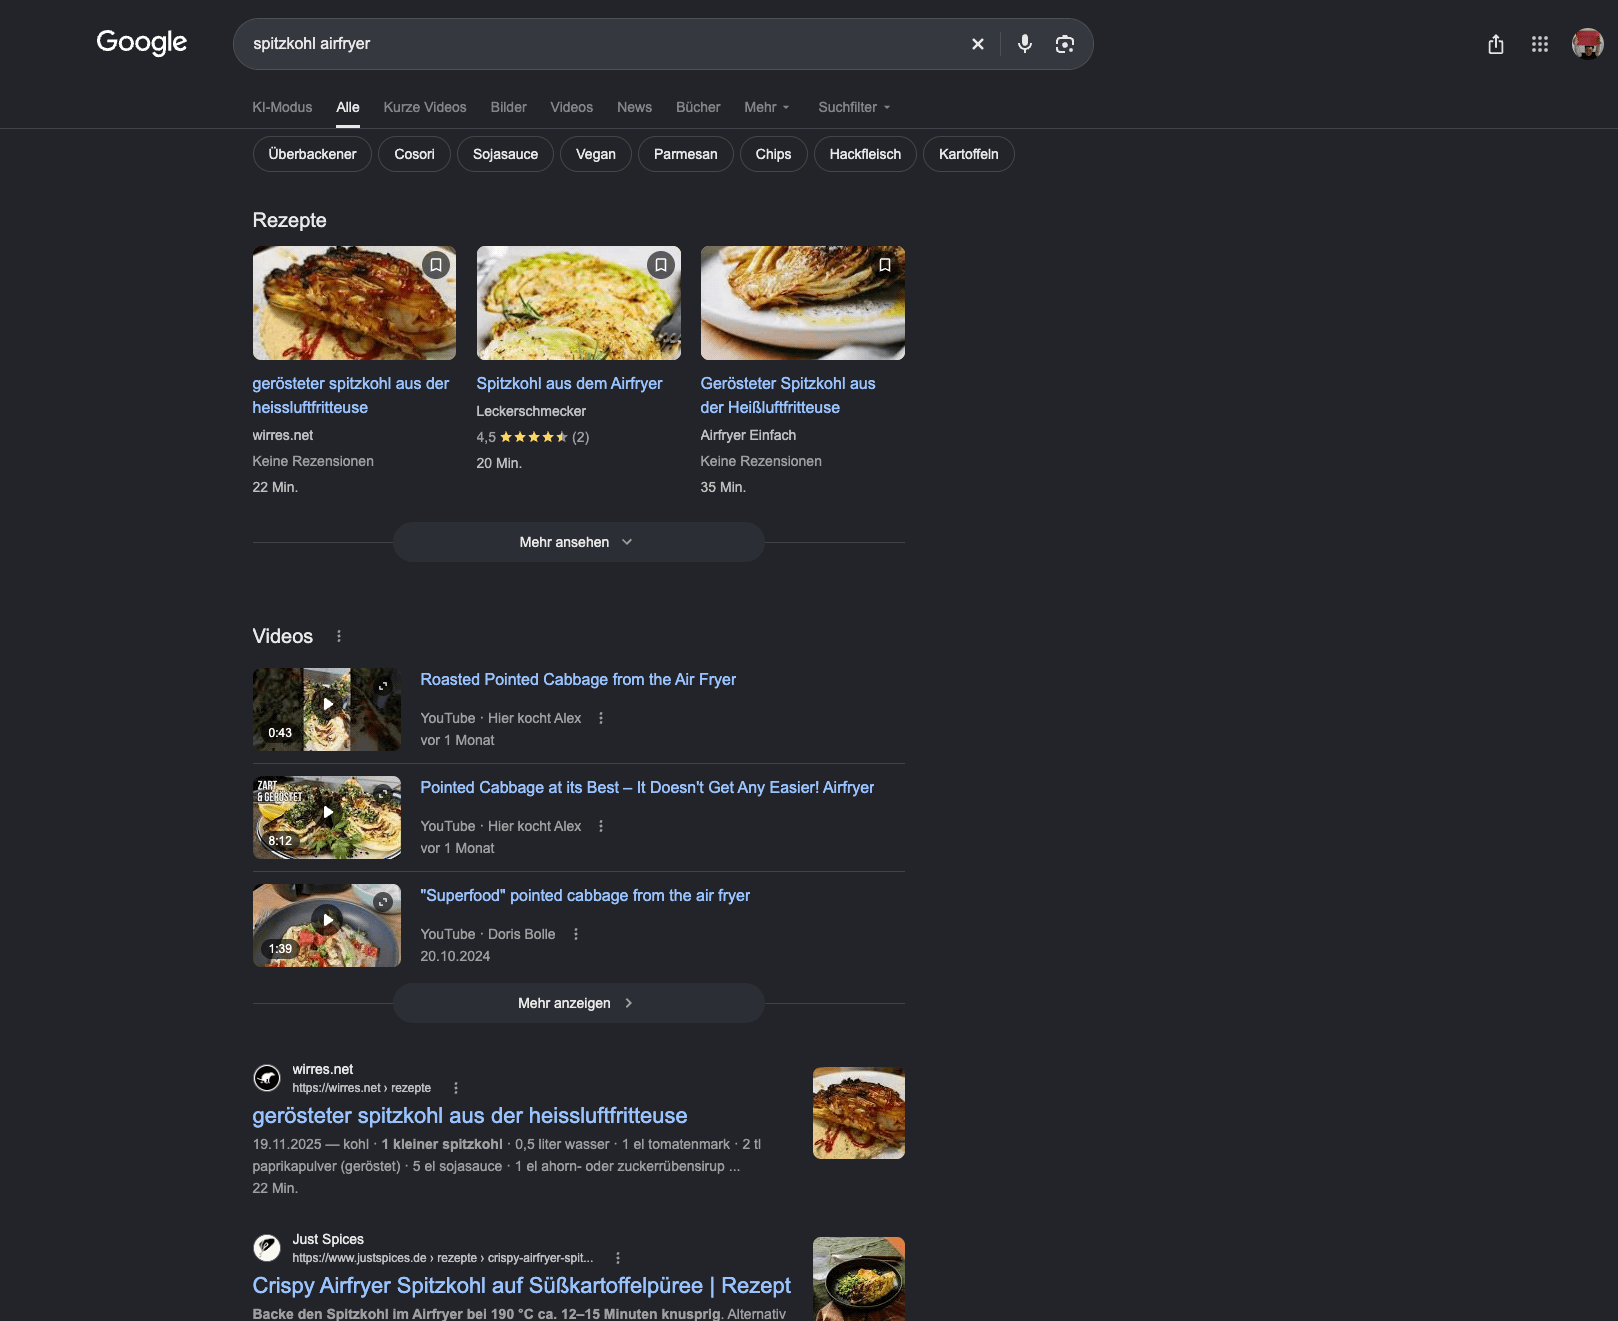


zur optimierung gehört auch darauf zu achten, dass die seite auch ohne css und js funktioniert. das kontrolliere ich auch gelegentlich und versuche die gröbsten fehler wegzuoptimieren, wenn ich welche finde. das würdevolle kaputtgehen oder in webdev-sprech: „graceful degradation“ ist eine der wichtigsten lektionen aus meinem architekturstudium und dem rumwüten in webdesgn-sphären. auch in meiner schreiner ausbildung versuchte ich so zu bauen, dass meine arbeiten auch nach einem einen schlag mit nem hammer noch gut aussehen. mauerwerk altert würdiger als vorhangfassaden, ein massivholztisch würdiger als ein spanplatten-tisch mit dünnen, aufgeleimten furnierkanten. die liste kann man unendlich weiterführen: putz / tapete, geöltes holz / lackiertes holz, parkett / laminat, terrazzo / laminat, verschraubt / verklebt, …
- css optimieren, verschlanken und pflegeleichter machen
- eine idee, die ich auf einem der letzten spaziergänge hatte: bookmarkvorschläge per webmention annehmen. auf indiewebnews kann man einen link zur eigenen seite posten, indem man erstens auf indiewebnews linkt und zweitens einen u-syndication-link anlegt. wenn man dann einen webmention sendet, landet ein link auf die eigene seite auf indiewebnews. so könnten mir auch andere ins-internet-schreibende links in die lesezeichensammlung legen.
- diese markdown checklisten (
* [ ]) im frontend korrekt rendern. - ein buch schreiben
- mehr bücher lesen
- ein strukturiertes, regelmässiges changelog schreiben
- ein manifest schreiben, in dem alle features dieser webseite generisch beschrieben sind und nach dem man diese webseite feature-complete nachbauen könnte. würde wahrscheinlich hunderte seiten lang werden und werde ich nie machen. aber ich hätte so ein manifest gerne für mein altes wirres.net gehabt, dass ich vor anderthalb jahren nach kirby migrierte. es hat mich immer wieder selbst erstaunt wie viele unsichtbare und sichtbare features ich da über die jahre eingebaut hatte. und ich habe nach anderthalb jahren immer noch nicht alles rekonstruiert.
- mit RSS.chat rumspielen
- mein blogroll-plugin auch für andere nutzbar(er) machen
- isso-kommentare auch ohne javascript zugänglich machen
- überschriften und absätze mit sprungmarken versehen (bei mouseover:
#). sieht vielleicht komisch aus und niemand weiss wozu es dient, gehört aber auf die to-do-liste. - anzeige im footer in welcher stadt ich gerade bin. kann stimmen, muss aber nicht, steuerung von meinem handy.
- ein weblog-log das ereignisse wie publish und edits erfasst, aber vielleicht auch shitvotes und andere likes. auf der rückseite site weit, in der artikelbeilage werden nur die artikel-relevanten ereignisse angezeigt.
… wird fortgesetzt und ergänzt.
keine reaktionen
(alle reaktionen in der beilage)
- likes
- erwähnungen
- reposts
- bookmarks
- kommentare
- aufrufe
Ich habe gerade alle XML Formate die ich in WordPress finden konnte, mit XSLT aufgehübscht und jetzt beschließen Google & Co. ernsthaft den Support einzustellen!?!?
Aber bevor ich weiter „rante“, hier ein kurzer Einschub was XSLT überhaupt ist: Mit XSLT lassen sich XML-Dateien in andere Formate umwandeln, zum Beispiel HTML. Man verlinkt dazu ein Stylesheet in der XML-Datei und der Browser übernimmt die Umwandlung. So wird aus einem RSS-Feed eine lesbare Webseite. Ohne JavaScript und ohne dass man dafür auf dem Server etwas installieren muss.
Für den Feed-Reader ändert sich dabei nichts. Der bekommt weiterhin die XML-Datei. Wenn ihr den Feed im Browser öffnet, seht ihr dagegen Beiträge, Links und eine Erklärung wie ihr ihn abonnieren könnt.
Ich benutze das hier seit einer ganzen Weile. 2020 hab ich meinen RSS-Feed mit XSLT und CSS gestaltet. Später kam die OPML-Ausgabe meines .well-known/feeds Plugins dazu. Und jetzt auch die OPML-Dateien meiner Blogroll. Screenshot des RSS-Feeds von notiz.blog im Browser, mit XSLT als lesbare Webseite dargestellt. Oben erklärt ein gelber Bereich mit RSS-Symbol, wie man den Feed abonniert. Darunter stehen das Blog-Logo, die Beschreibung und die neuesten Beiträge als anklickbare Links.
Bei OPML finde ich das besonders praktisch: Ihr klickt auf den Link und bekommt eine Liste von Blogs durch die ihr stöbern könnt. Die gleiche URL könnt ihr in euren Feed-Reader importieren. Man muss nicht einmal wissen was OPML ist um etwas damit anfangen zu können.
@ix hat auch gerade nochmal über seine Basteleien geschrieben. Er hübscht seine OPML-Dateien auch mit XSLT auf und inzwischen auch seine RSS-Feeds.
Die generelle Idee hinter XSLT erinnert mich sehr an den Microformats-Grundsatz:
Designed for humans first and machines second microformats.org
Bei Microformats ergänzt man das HTML einer Webseite so, dass auch Software etwas damit anfangen kann. Das gleiche HTML für Menschen und Maschinen. Bestehendes sinnvoll erweitern, mit dem arbeiten was schon da ist.
XSLT macht im Prinzip das Gleiche, nur aus der anderen Richtung:
Designed for machines first and humans second
Die XML-Dateien bleiben für Maschinen lesbar. Mit einem Stylesheet können aber auch Menschen etwas damit anfangen.
RSS und OPML sind ein wesentlicher Bestandteil des Open Webs. Wir verlinken sie an so vielen Stellen, weil wir wollen dass Besucher es einfach haben den Blog zu abonnieren oder weil wir ihnen neue Links vorschlagen wollen. Was sie in Zukunft sehen werden ist reines XML. Keine Möglichkeit irgendetwas zu erklären oder auf das Wesentliche aufmerksam zu machen! Nur XML!
Leider ist das auch keine rein theoretische Diskussion mehr. Stand 5. Oktober 2026: Chrome: XSLT ist bereits deprecated. Die Abschaltung ist für Chrome 158 am 17. November 2026 geplant. Befristete Ausnahmen für registrierte Websites und verwaltete Browser sollen am 17. August 2027 enden. Betroffen sind sowohl die Verknüpfung mit einem XSLT-Stylesheet als auch die JavaScript-API XSLTProcessor. Zeitplan von Chrome Firefox: Mozilla hat die Abschaltung für August 2027 angekündigt. Intent to Unship Safari/WebKit: WebKit unterstützt die Entfernung grundsätzlich, formuliert seine Zustimmung aber vorsichtig. Einen verbindlichen Abschalttermin habe ich in den geprüften Quellen nicht gefunden. WebKits Stellungnahme
Bei Chromium ist die Entfernung bereits beschlossen. Noch ist XSLT aber nicht aus allen Browsern verschwunden und auch die Änderung am HTML-Standard ist noch offen.
RSS, Atom und OPML funktionieren natürlich weiter. Entfernt wird die XSLT-Verarbeitung im Browser. Der Reader kann meinen Feed also weiterhin lesen, aber wer auf den Link klickt bekommt die XML-Ansicht.
Die Begründung der Browserentwickler sind Sicherheitslücken, Wartungsaufwand und geringe Nutzung. Das sind alles nachvollziehbare Argumente. Trotzdem finde ich den Verweis auf JavaScript und moderne Frameworks als Ersatz unbefriedigend. Ich hab eine XML-Datei und ein Stylesheet. Für das was ich damit machen will hat das bisher gereicht!
Was können wir stattdessen machen? XSLT mit JavaScript nachrüsten. Es gibt einen Polyfill mit WebAssembly, den man direkt in die XML-Datei einbindet. Der Browser führt damit das Stylesheet aus, der Reader bekommt weiterhin XML. Das könnte die bisherige Darstellung unter der gleichen URL erhalten. Allerdings dokumentiert das Projekt Unterschiede zur eingebauten XSLT-Verarbeitung, etwa beim Nachladen weiterer Dateien. Ob es mit meinen Stylesheets und den Readern funktioniert müsste ich ausprobieren. XML mit CSS gestalten. Das bleibt möglich. Die gleiche XML-Datei lässt sich damit im Browser lesbar darstellen, für Reader ändert sich nichts. CSS kann aber nicht alles was XSLT kann: Aus einer URL in einer OPML-Datei wird dadurch noch kein anklickbarer HTML-Link. Für eine einfache Ansicht kann es trotzdem reichen. HTML und XML unter der gleichen URL ausliefern. Mit Content Negotiation könnte der Server anhand des Accept-Headers entscheiden welche Version er zurückgibt. Nur für die HTML-Version würde ich XSLT auf dem Server ausführen, Reader müssten weiterhin das ursprüngliche XML bekommen. Eine zusätzliche öffentliche URL braucht es dafür nicht. Der Haken: Browser und Reader lassen sich über den Header nicht zuverlässig auseinanderhalten. Das müsste ich mit verschiedenen Readern testen. Caches brauchen außerdem Vary: Accept damit sie die Versionen nicht verwechseln.
Ganz ehrlich? Das ist alles 💩 und keine wirkliche Alternative!
Gewöhnt euch lieber schon mal wieder an XML!