zeiterfassung 11.11.2026
johannes kuhn nennt das „notizblog“, caro (und einige andere) 12 von 12, ich nenne es tagebuchbloggen oder heute mal zeiterfassung.
→ lesen …johannes kuhn nennt das „notizblog“, caro (und einige andere) 12 von 12, ich nenne es tagebuchbloggen oder heute mal zeiterfassung.
→ lesen …bei niklas gesehen, dass er seinem blog threads beigebracht hat. niklas hat es bei marcel gesehen. weil ich jetzt über drei beiträge hinweg über französischen whisky geschrieben habe, dachte ich mir: warum nicht auch threads bauen, mit denen ich zusammenhängende beiträge zu einem strang verknüpfen kann?
ich finde die lösung elegant. im backend kommt einfach jeder beitrag eine verknüpfung auf den ersten beitrag, kirby baut das dann alles entsprechend zusammen. auf übersichtseiten und im rss bleibt alles wie vorher, nur die einzelnen beiträge werden etwas umfangreicher.
im ergebnis ungefähr das gleiche wie bei meinem zeiterfassungs-beitrag, aber dann doch ein bisschen anders.
ich mach je bei fast jedem neuen technik-scheiss mit. also auch bei socialspec.org und in der folge auch bei sodir.org/profile.html?d=wirres.net.
bei der gelegenheit die /about und /kontakt seiten aufgeräumt und so aufgebaut, dass sie automatisch /.well-known/about.md und /.well-known/contact.vcf füttern.
nachtrag 06.11.2026:
jan montag erklärt sehr schön die hintergründe von socialspec und warum man das interessant finden kann.
thomas hat sich swarm selbst (nach) gebaut.
Seit März 2011 logge ich mich mit Hilfe von Foursquare/Swarm an Orten ein.
Insgesamt 3004 Check-ins zeigt mir die App an.Swarm wirkt aus der Zeit gefallen. Die App ist irgendwie stehengeblieben (und ich liebe das), weil sie sich nicht gewandelt hat. Sie wollte nie mehr sein, als sie ist – es gab keine Enshittification. Bis jetzt.
Jetzt wurde das Unternehmen Foursquare verkauft. An eine Ad-Tech-Firma.
Und ich denke, das ist der Zeitpunkt ‚Adieu‘ zu sagen.
so sieht das bei thomas aus, wenn man dreitausendmal irgendwo „eincheckt“:

ich nutze foursquare/swarm seit 13 jahren und zähle ca. 1000 checkins. so richtig verstanden habe ich das einchecken nie. foursquare selbst verstand ich, das war vor 10 jahren ein ganz brauchbares tool für restaurant- oder sehenswürdigkeitssuche an fremden orten. das macht man heute mit google maps, auch wenn das mittlerweile auch kaputt ist, weil google maps für unternehmen so wichtig geworden ist, dass sämtliche negativ-bewertungen weg-beschwert werden.
seit 2025 nutze ich swarm wieder aktiv, um bilder und orte via ownyourswarm in wirres.net zu schaufeln. ungefähr 260 checkins haben sich so seit ende 2025 angesammelt. bilder und orte kann ich auch anders ins blog schaufeln, aber mit swarm und ownyourswarm finde ich das besonders einfach. so checke ich jeden tag, wenn ich dran vorbeikomme, an einem bestimmten baum in den rehbergen ein.
anders gesagt: swarm interessiert mich eigentlich nur minimal, aber es ist ein ganz gutes werkzeug um mein blog mit geogetaggten bildern zu füllen. so sieht das im ergebnis bei mir aus:

an der zahl der einträge auf der karte sieht man, dass die 260 checkins nur einen kleinen teil meiner beiträge mit geotags ausmachen. auch meine instagram-importe („sofortbilder“) haben geoinformationen und auch normale beiträge bekommen — sofern sinnvoll — geoinformationen angehängt.
dass foursquare von einem ad-tech-anbieter aufgekauft wirde hab ich erst bei thomas erfahren. aber solange die app funktioniert werde ich überall dort, von wo ich mal eben schnell ein foto posten will, einchecken. und wenns nicht mehr geht, mach ichs dann mit quill. das geht genau so einfach, nur mit ein paar klicks mehr — und am ende landet eh alles hier.
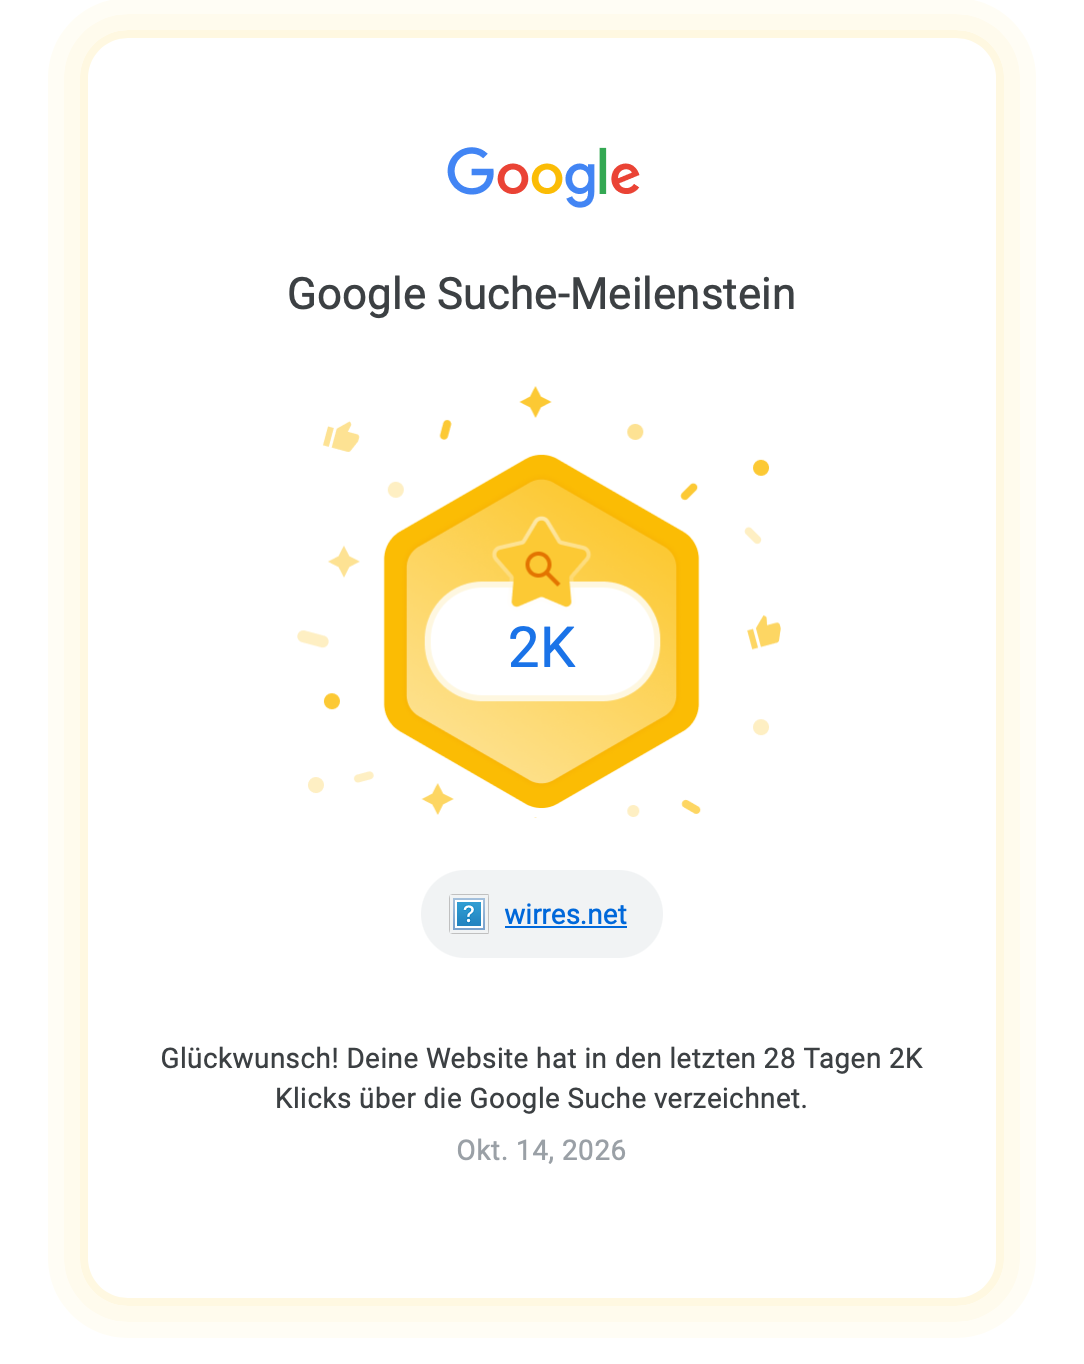
vor 10, 15 jahren war wirres.net wirklich gut bei google vertreten. beiträge wanderten nach wenigen minuten in den suchindex. mit 5 jahren blogpause ging die sympathie von google für wirres.net den bach runter. google schickte niemandem mehr rüber und wirres.net war in der versenkung des suchindex verschwunden.
in den letzten 6 monaten ging es wieder bergauf. und ich bild mir ein, dass die anzahl der klicks höher als jemals zuvor ist. allerdings muss man auch sagen, dass ein grossteil der klicks durch eine seite generiert werden (machmal um die 100 besucher/tag, aktuelle summe der mit matomo aufgezeichneten besucher der seite: 8081).

ifttt.com habe benutzt seit es ifttt gibt. drüber geschrieben hab ich mal 2013 und 2014. ifttt.com war ein wahrgewordener traum für mich. unkomplizierter zugriff auf alle möglichen APIs und damit mal eben schnell was bauen oder ausprobieren. aber alles schöne hat ein ende und das erste ende hat ifttt um das jahr 2020 selbst einegführt als fast alle dienste und applets kostenpflichtig wurden oder ein kostenpflichtiges konto benötigten. ich habe das noch bis jetzt mitgespielt weil ich keinen anderen weg fand die daten von meiner selbstgebauten waage in die ios health app zu schaufeln.
diesen weg habe ich jetzt gefunden und mein ifttt-konto gekündigt, für das ich die letzten 6 jahre so um die 5 euro monatlich bezahlt habe.
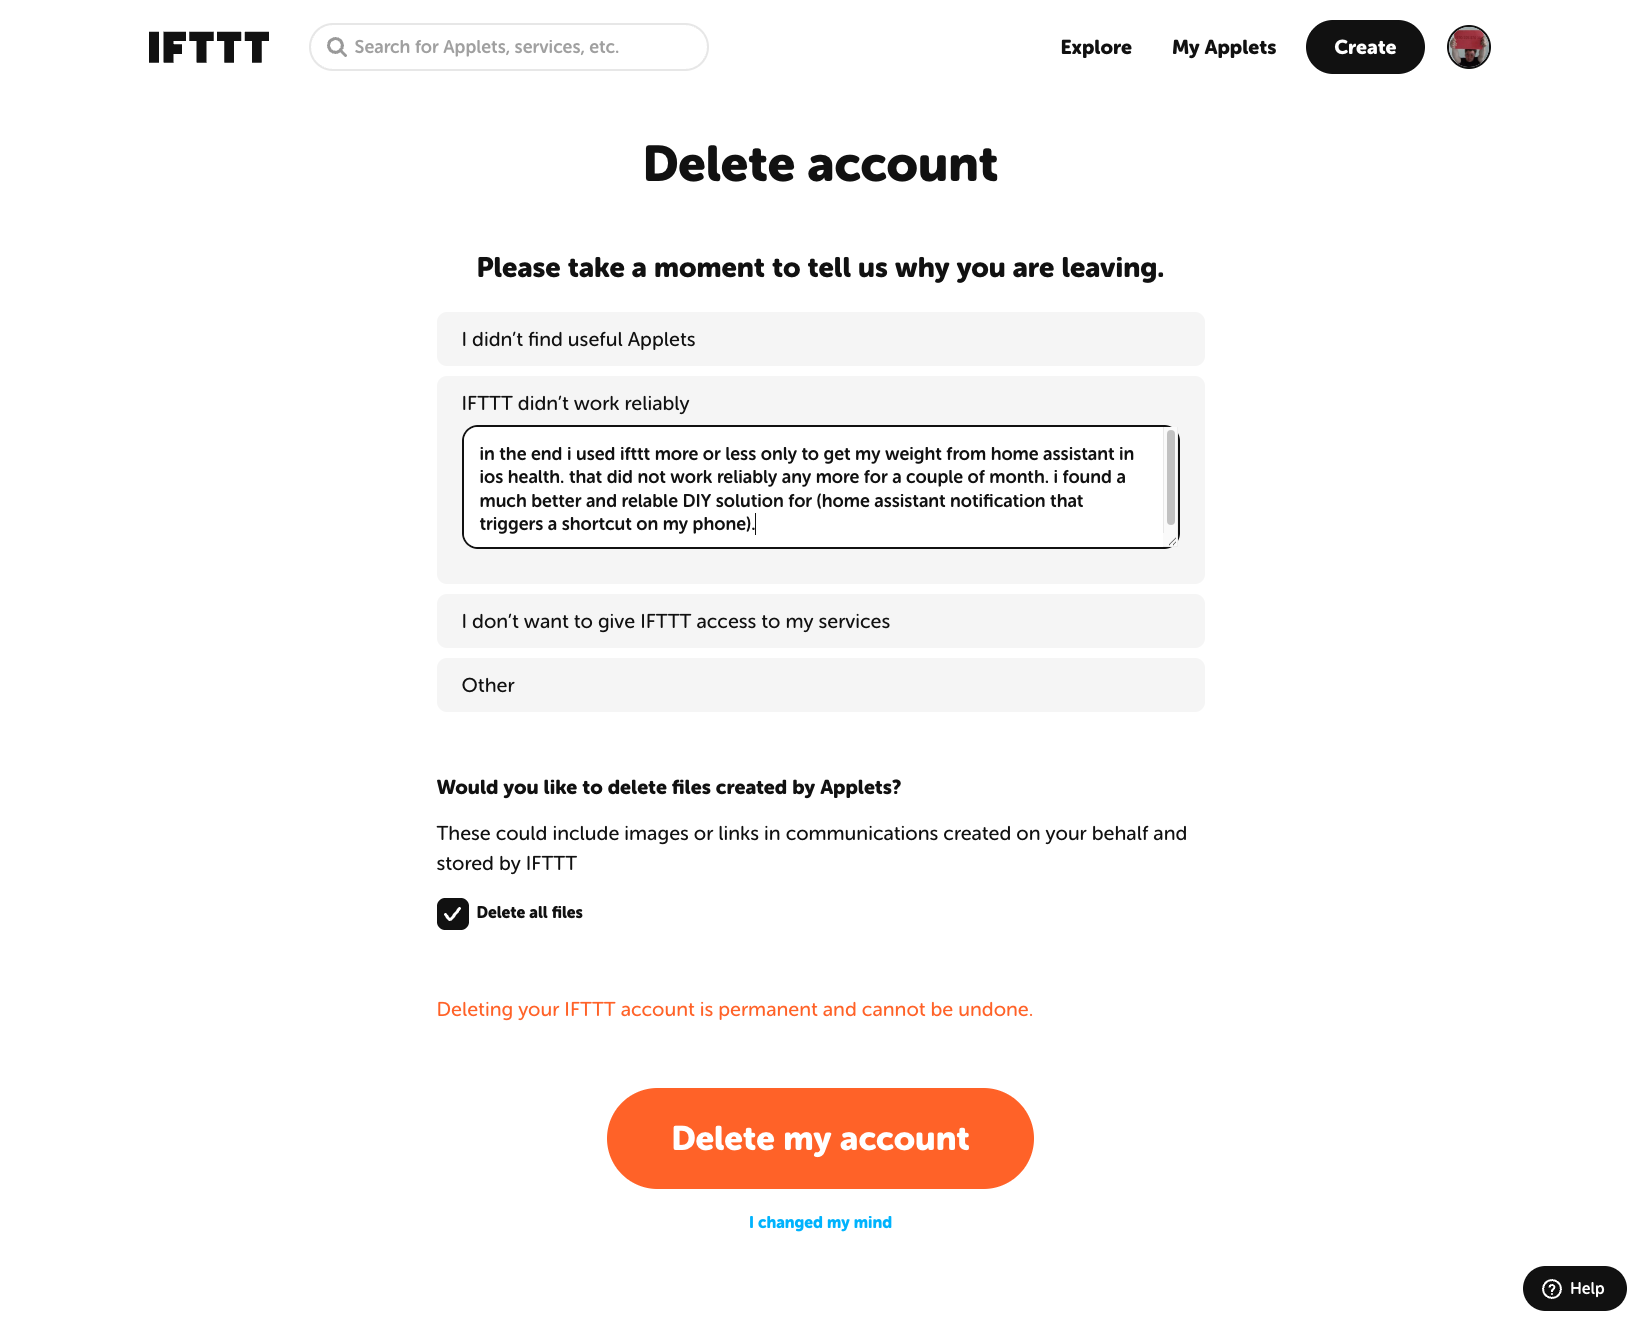
in the end i used ifttt more or less only to get my weight from home assistant in ios health. that did not work reliably any more for a couple of month. i found a much better and relable DIY solution (home assistant notification that triggers a shortcut on my phone).
bevor ich den shortcut beschreibe, mit dem ich jetzt tatsächlich zuverlässig mein gewicht in ios health bekomme, nochmal ein paar worte dazu, was auch nicht zuverlässig funktioniert hat.
es gibt mehrere apps die exakt meinen usecase abbilden: daten aus home assistant aufs telefon oder umgekehrt schicken:
weil diese apps alle dazu gezwungen sind im hinttergrund des telefons zu arbeiten, hakelte es immer wieder beim eintragen meines gewichts in die ios health app. ausserdem: warum mit ner kanone auf spatzen schiessen, bzw. auf ein datum mit ner app schiessen?
meine lösung: home assistant sendet, sobald ich mich gewogen habe, ein benachrichtigung an mein telefon:
automation:
- id: gewicht_ix_apple_health_shortcut
alias: Gewicht ix → Apple Health
description: Notify mit Prefix HAWEIGHT → iOS prüft Message im Wenn-Block
mode: single
triggers:
- trigger: state
entity_id: sensor.gewicht_ix
not_to:
- unknown
- unavailable
conditions:
- condition: template
value_template: "{{ trigger.from_state.state != trigger.to_state.state }}"
actions:
- action: notify.mobile_app_ixr
data:
title: Gewicht
# Prefix für Shortcut-Wenn. Komma beibehalten (Punkt → 926 kg).
message: >-
HAWEIGHT:{{ states('sensor.gewicht_ix') | float(0) | round(1)
| string | replace('.', ',') }}
data:
tag: gewicht_ix_health
# Shortcut braucht etwas Zeit; clear via Companion-Tag (kein HA aus Shortcuts)
- delay:
seconds: 60
- action: notify.mobile_app_ixr
data:
message: clear_notification
data:
tag: gewicht_ix_health
auf ios seite triggert das einen shortcut. shortcuts können seit ios 27 (endlich) auch ohne mein zutun von benachrichtigungen getriggert werden. das ging vorher nur mit einem klick auf die benachrichtigung. so ist der shortcut aufgebaut:
TRIGGER:
Mitteilung von "Home Assistant"
Titel enthält "Gewicht"
# weil der Filter nach Titel nicht zuverlässig funktioniert
# werden die Home Assistant-Mitteilungen hier nochmal gefiltert.
WENN Mitteilung.Text "HAWEIGHT" enthält:
Ersetze "HAWEIGHT:" in Mitteilung.Text durch ""
SONST:
Kurzbefehl stoppen
ENDE WENN
Wenn-Ergenis in eine Zahl umwandeln
Protokolliere Health-Messung:
Typ: Gewicht
Wert: Zahl (kg)
Datum: Standardwert
ich hatte noch eine zweite automatisierung bei ifttt: sobald ich ein youtube video gefavt habe, führte ifttt einen webhook aus, der dann in kirby das anlegen eines favoriten für das youtube-video auslöste. statt die youtube-api abzufragen, prüft kirby jetzt den RSS-feed einer playlist und holt alle paar minuten neu hinzugefügte videos in kirby.
roman jasiek hat es mehrfach auf seiner seite erwähnt und schreibt es auch gerne in kommentarspalten:
[Ich denke], dass eine große Chance für Blogger darin besteht, die Inhalte per Newsletter an die eigene Leserschaft auszuspielen.
als ich vor acht monaten mal testweise einen newsletter mit mailchimp gebaut habe, meldete sich exakt eine person an: meine mutter. kurz danach schoss mailchimp den newsletter dann ab, angeblich wegen verstössen gegen mailchimps „Richtlinie zur zulässigen Nutzung“.
ich habe meiner mutter dann auf meinem heimischen linux server ein script installiert (rss2mail), dass den /feed einliest und für jeden neuen beitrag eine mail an meine mutter (und mich) schickt. das funktioniert jetzt seit 8 monaten sehr zuverlässig und fehlerfrei. meine mutter freut sich, meint sie würde alles lesen, auch das was sie nicht versteht oder was sie nicht interessiert.
RSS ist für meine mutter keine option: dafür brauchts eine eigene app, die konfiguriert werden müsste und dann auch noch auf telefon, ipad1 und ipad2 installiert werden müsste. dann müsste sie die auch noch öffnen, was sie mit ihrer email-app ohnehin jeden tag (oder mehrfach am tag) macht.
für mich ist die kopie praktisch, weil ich so gelegentlich fehler sehe, die ich sonst nicht sehe und eine art backup isses auch.
jedenfalls dachte ich: auch wenn sich niemand für einen wirres.net newsletter interessiert, könnte ich den mailversand ja trotzdem anbieten auf meiner /folgen seite.
wer also wirres.net per email bekommen möchte kann ich auf meiner zuhause betriebene rss2mail-instanz hinzufügen. diese versendet für jeden auf der startseite veröffentlichten artikel eine email mit dem vollen inhalt. die email wird über mein privates google-mail-konto (im bcc) als html-mails versendet. email an ix ät wirres punkt net reicht, dann trage ich die adresse manuell ein.
die emails sehen so aus:
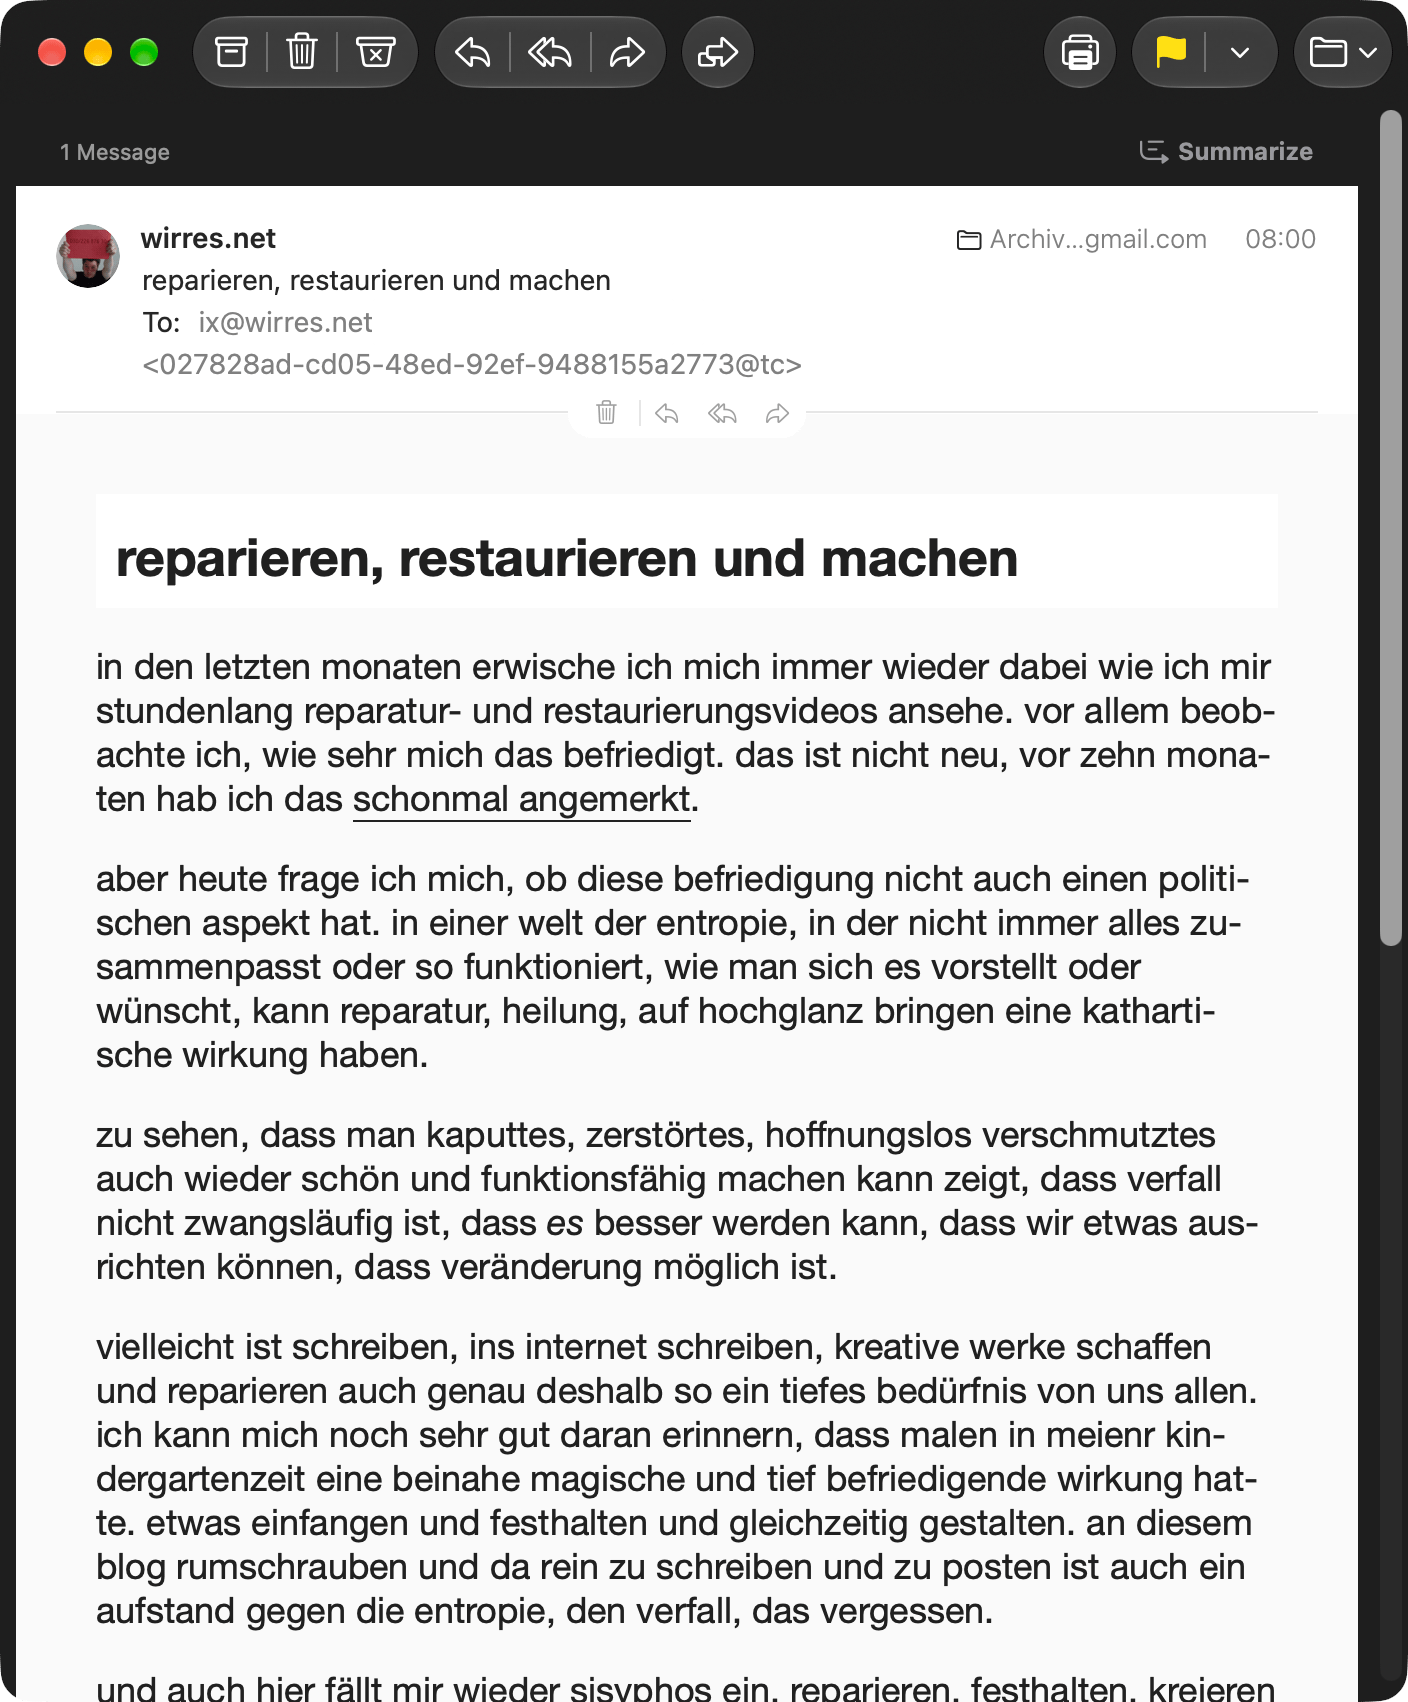
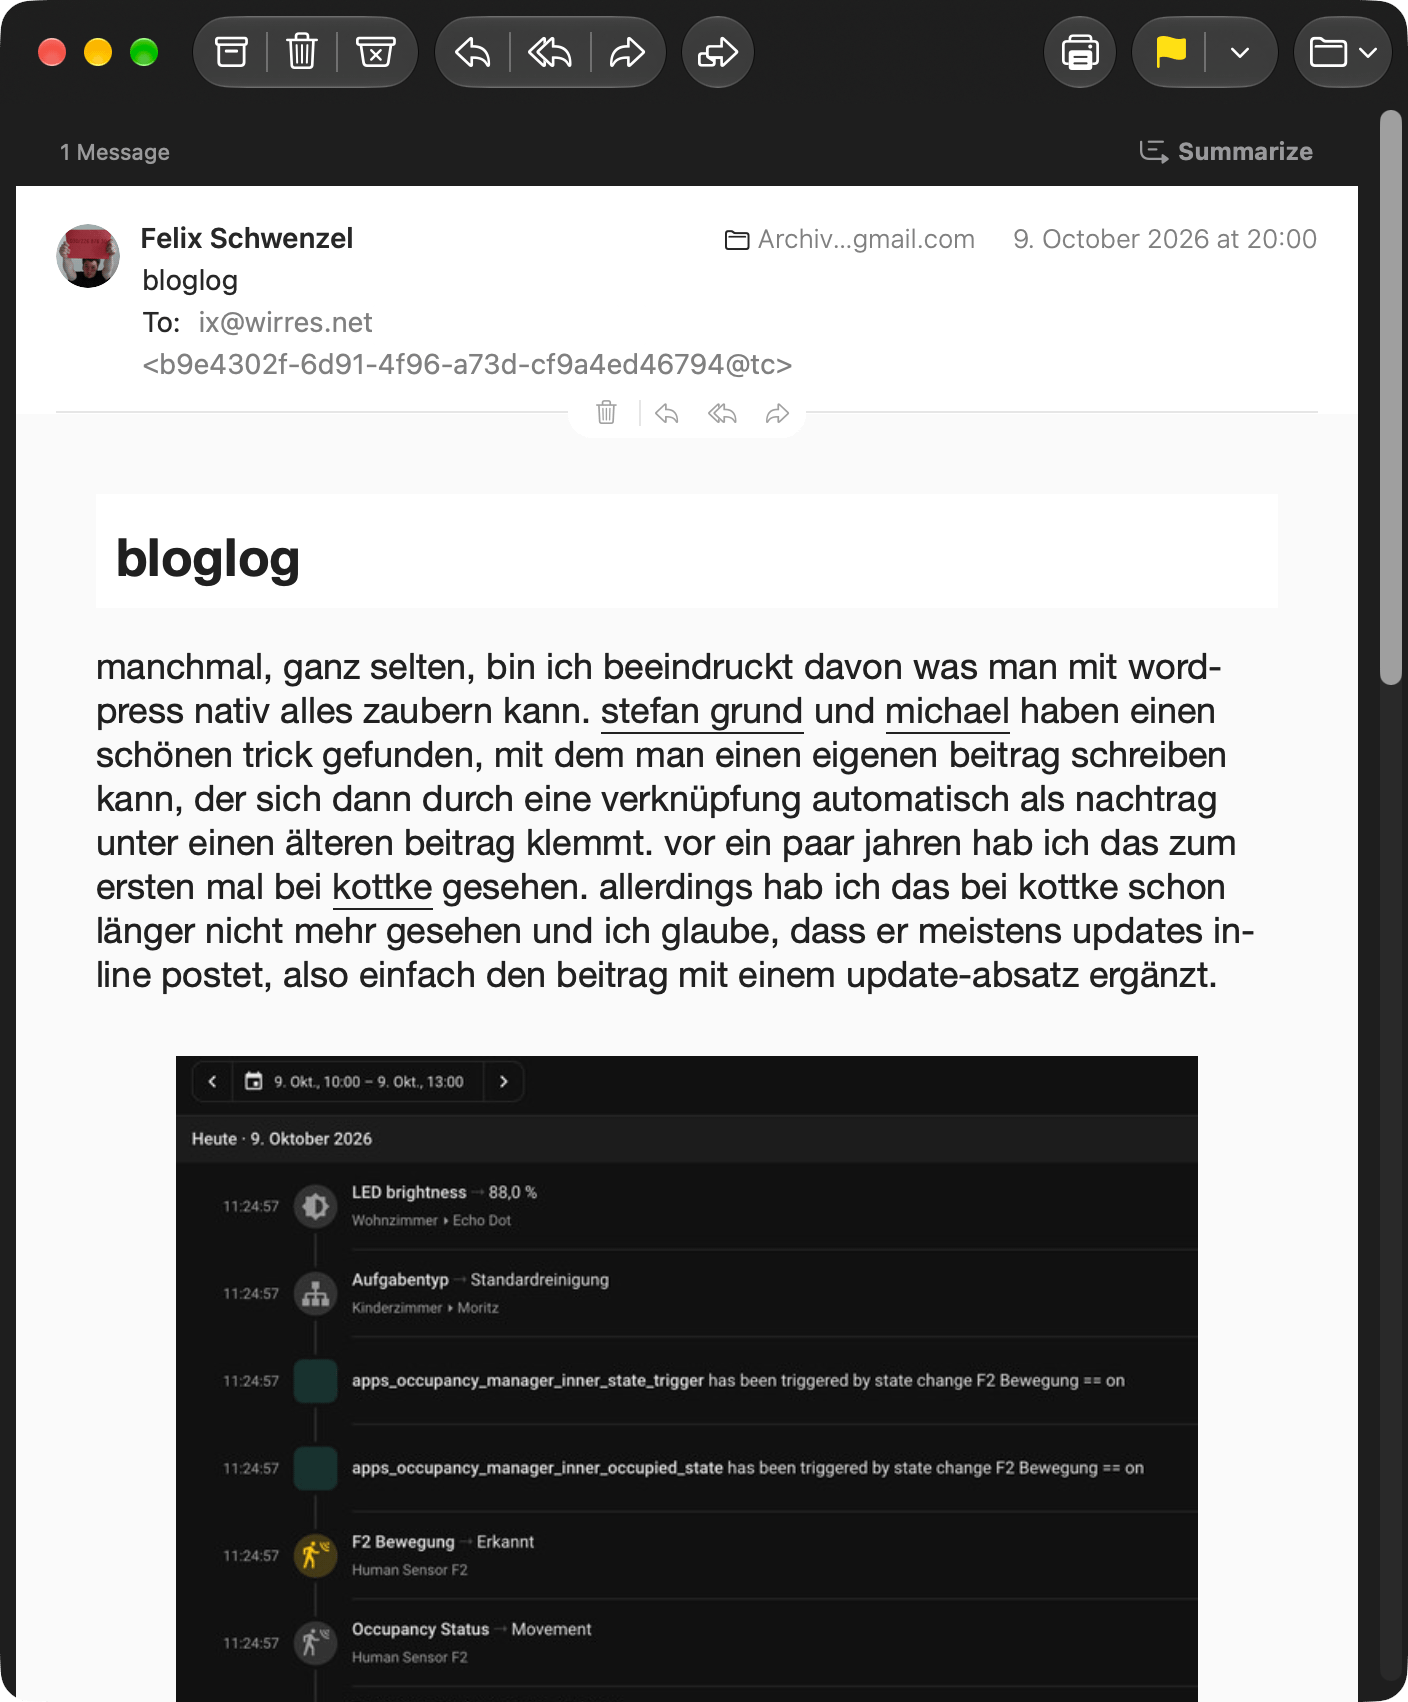
hier die mails als .eml zur voransicht:
manchmal, ganz selten, bin ich beeindruckt davon was man mit wordpress nativ alles zaubern kann. stefan grund und michael haben einen schönen trick gefunden, mit dem man einen eigenen beitrag schreiben kann, der sich dann durch eine verknüpfung automatisch als nachtrag unter einen älteren beitrag klemmt. vor ein paar jahren hab ich das zum ersten mal bei kottke gesehen. allerdings hab ich das bei kottke schon länger nicht mehr gesehen und ich glaube, dass er meistens updates inline postet, also einfach den beitrag mit einem update-absatz ergänzt.
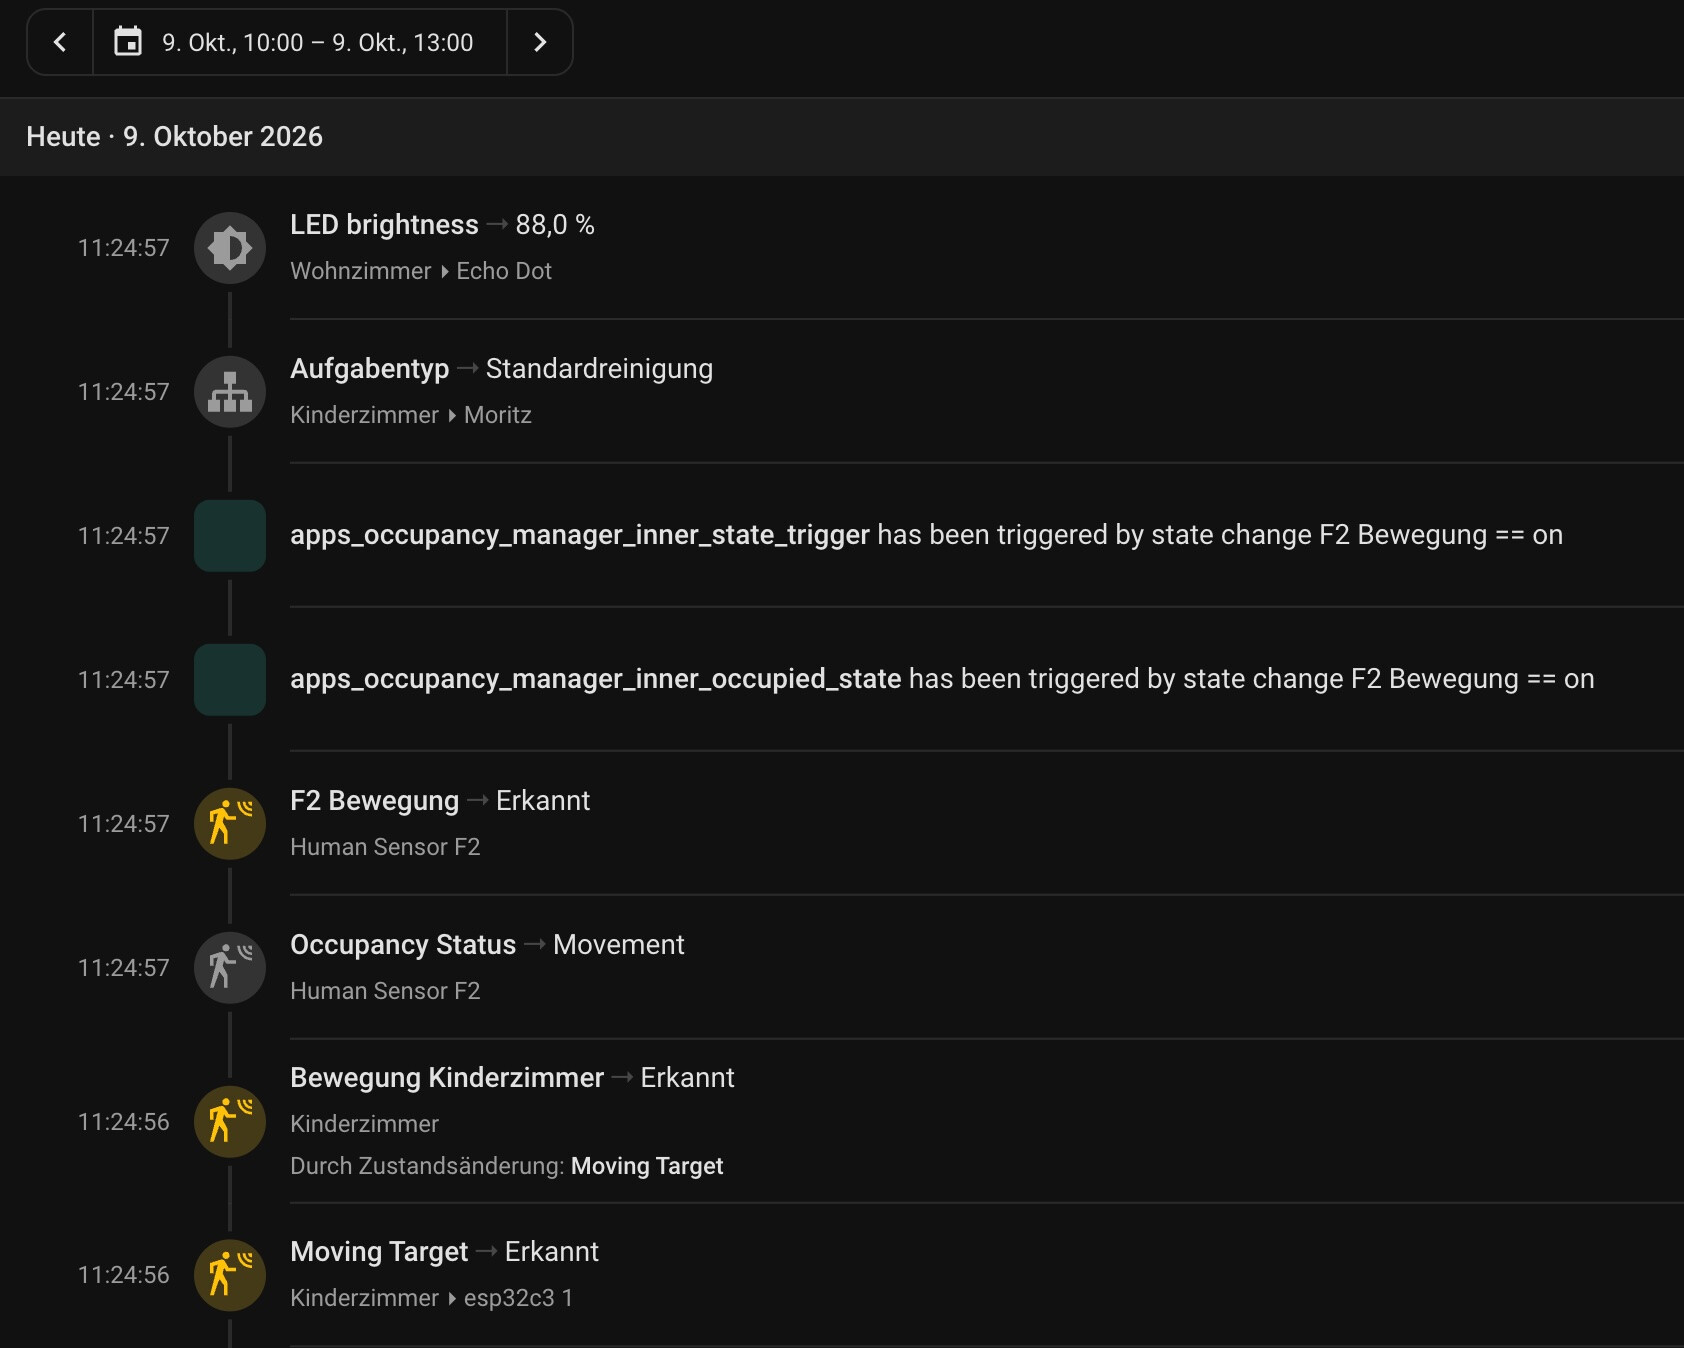
ich war kurz versucht das feature nachzubauen, hielt dann aber inne. denn ein paar tage vorher hatte ich die idee ein log fürs blog zu bauen. die idee kam mir, weil ich, seit das drücken der poo-endmarke in artikeln nicht nur herzen versprüht, sondern auch ein geräusch in meinem zimmer macht, nie wusste wo denn nun jemand die kacke gedrückt hat. von home assistant kenne ich das aktivitätslog, mit dem man die letzten ereignisse und zustände von geräten und sensoren nachverfolgen kann. warum nicht auch ein logbuch für ein weblog?
technisch ist das unkompliziert: so wie ein drücken des kackicons unter beiträgen einen webhook auslöst um den tusch bei mir im zimmer abzuspielen, kann es auch einen eintrag in einer json-datei anlegen. auch alle anderen ereignisse in kirby haben hooks die — wenn man das will — in ein separates log schreiben können.
ich erfasse erstmal nur die shitvotes, neue beiträge, änderungen an bestehenden beiträgen (leicht dedupliziert) und isso-kommentare.
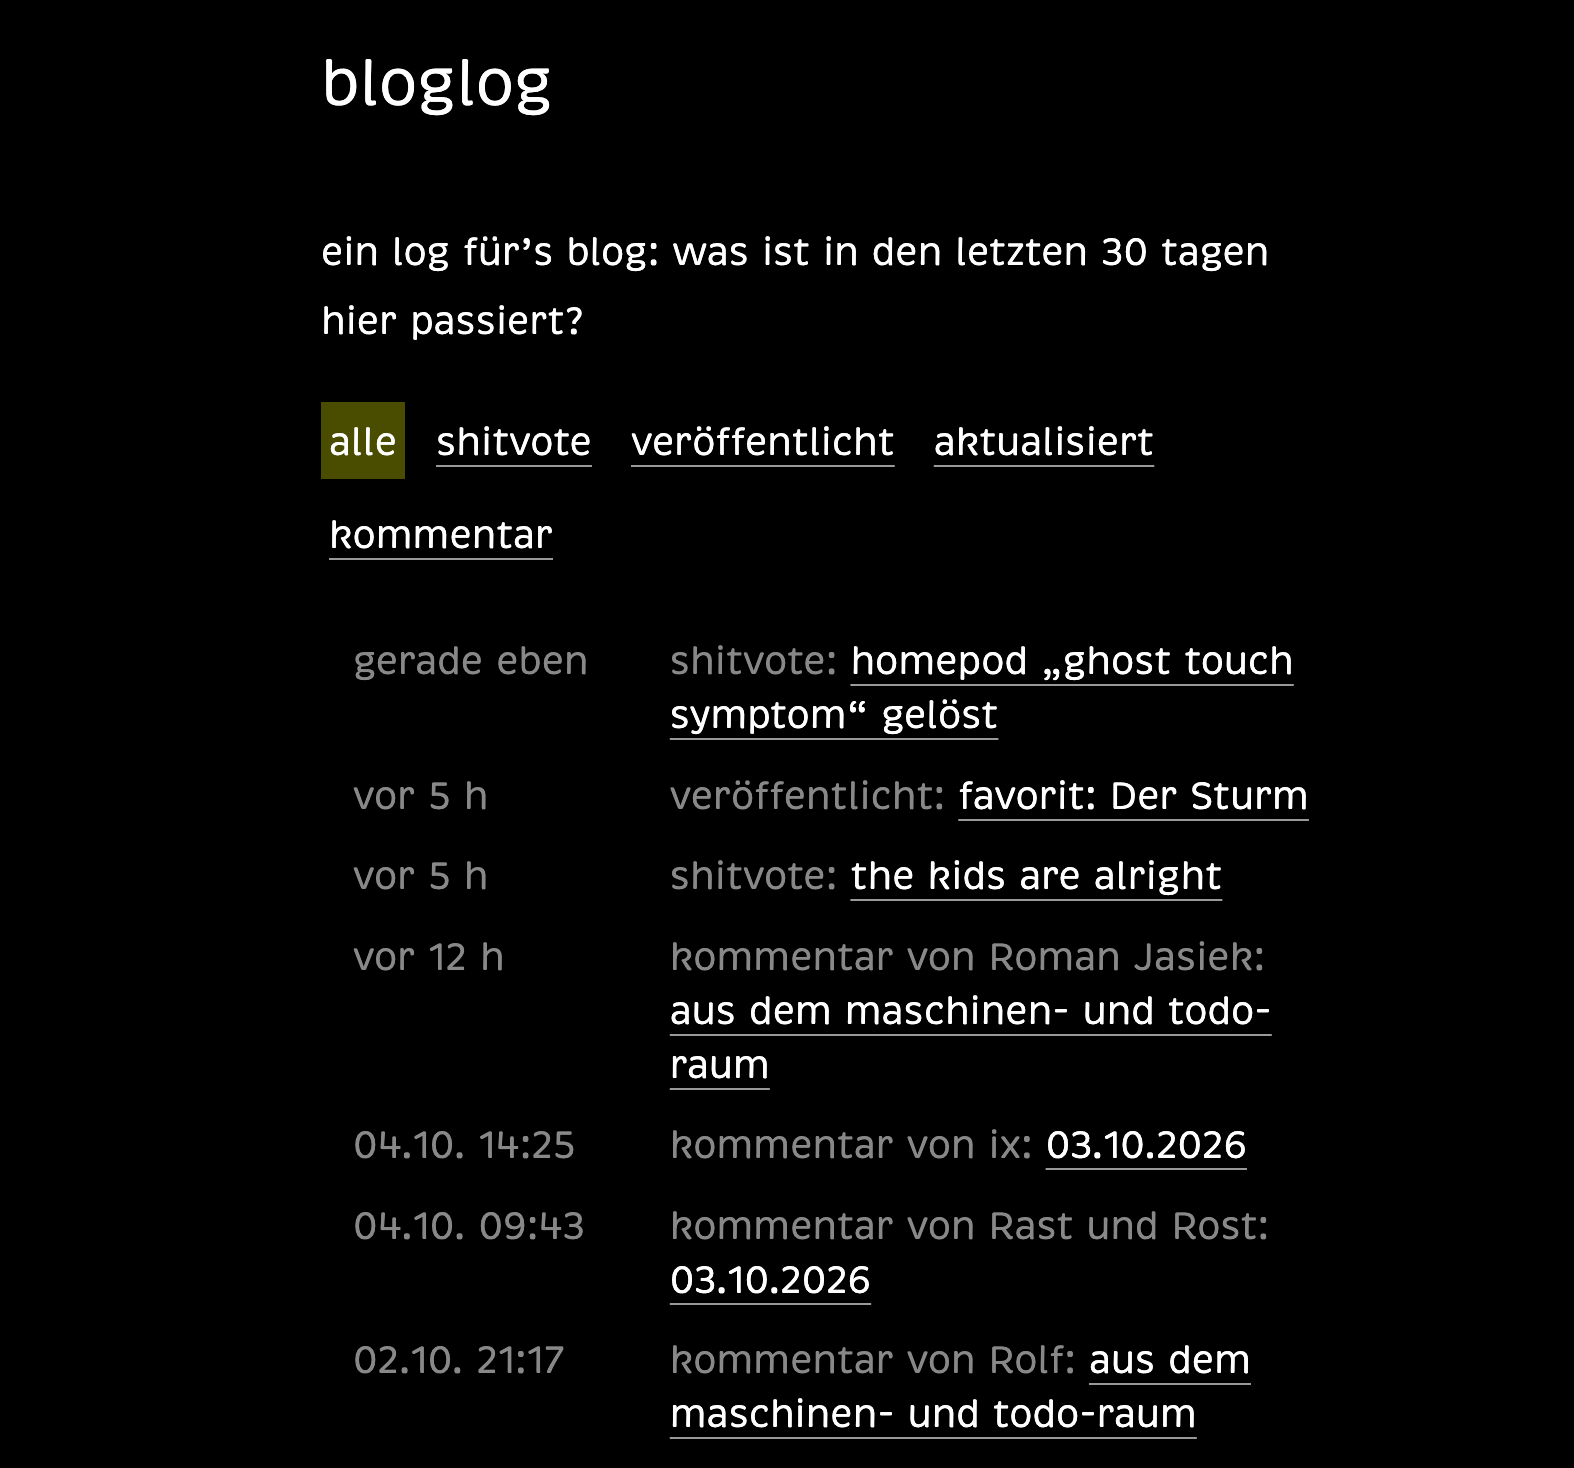
so sieht das globale bloglog dann aus: /bloglog
auf der rückseite steht eine verkürzte version des bloglogs. einzelne artikel-logs hab ich noch nicht umgesetzt, aber die kommen dann in die beilage, in der man dann die änderungshistorie und ereignisse rund um einzelne beiträge ablesen kann. damit bleibe ich erstmal bei inline-nachträgen in beiträgen.
nachtrag 10.10.2026:
beitrags-logs werden jetzt auch in der beilage angezeigt.
beim lesen der folgenden artikel fielen mir lauter kleinigkeiten auf, die ich mal wieder aufschreiben wollte.
notiz.blog: Ich hab‘ gerade wieder Spaß…
…an meinem Blog herum zu basteln ♥️!
I keep a list of things I want to do for KDO in Apple Notes, organized into four sections: small, medium, large, and longshots/obsolete.
Ich habe Ferien gemacht und einiges – ich korrigiere: vieles – hier technisch auf Vordermann gebracht.
dieser artikel wiederholt vieles was ich gelegentlich schon mal aufgeschrieben habe und ist eher technisch. also für die meisten hier mitlesenden sicherlich uninteressant. ich habe aber trotzdem das bedürfnis gehabt, das alles mal aufzuschreiben, sozusagen als quartalsweise bestandsaufnahme.
wenns ums machen, konstruieren, herstellen geht ist das wichtigste: gute werkzeuge. aber gute werkzeuge sind wiederum nichts wert, wenn man keinen plan hat, wenn man nicht weiss, was man mit den werkzeugen herstellen oder formen will. und zu wissen, was man machen will ist wiederum wenig wert, wenn man keinen blick fürs grosse und ganze, für den kontext hat.
wenn ich an meiner eigenen webseite rumbastel bin ich bauherr, architekt, fachingenieur, bauleiter und handwerker in personalunion. als bauherr formuliere ich anforderungen und ziele, als architekt entwickle ich das gesamtkonzept, sollte aber immer auch den blick aufs grosse und ganze haben, also die webseite, aber auch den kontext (das web). als architekt und fachingenieur sollte ich wissen was gerade state of the art ist und wie man einerseits erprobte techniken anwendet und trotzdem hier und da innovativ sein könnte. als handwerker sollte ich die geeigneten werkzeuge, liebe zum handwerk und sorgfalt mitbringen.
natürlich muss man das alles nicht in personalunion machen, die klassische arbeitsteilung funktioniert weiterhin. aber mir macht gerade das basteln an meiner website als generalunternehmer spass. oder genauer, der spass, die interessanz, steckt gerade im prozess, in der langfristigen interaktion der verschiedenen rollen. ich als bauherr habe ständig neue ideen und anforderungen an die webseite. ich als architekt erfahre ständig von neuen techniken, neuen materialien, effizienteren verfahren. der fachingenieur in mir sieht neue best practices, neue testverfahren, neue normen, der bauleiter entdeckt immer wieder neue begabte handwerker oder möglichkeiten readymades einzusetzen.
ich verstehe menschen gut, die einfach einen ort zum ablenkungsfreien schreiben haben wollen und sich eigentlich um nichts anderes kümmern wollen. aber mich fasziniert das ständiges rumbasteln und ausloten der möglichkeiten.
mir fallen beim schreiben ständig dinge ein, die ich vielleicht haben können wollte. fussnoten, verknüfpungsmöglichkeiten, die mir ermöglichen dinge besser zu strukturieren oder sinnvoll zu verknüpfen. möglichkeiten das geschriebene auch zu illustrieren oder, je nach kontext, auch mal anders zu gestalten. bei wiederkehrenden problemen fällt mir beim schrieben, nach dem hundersten stolpern, plötzlich eine lösung ein. oft schreibe ich beiträge um ein technisches feature das mich fasziniert auszuprobieren.
eine webseite wie eine wohnung zu beschreiben ist gar nicht so weit weg von der realität. was man sich bei der planung ausdenkt, funktioniert im alltag und im verlauf der zeit nicht immer so, wie man es mal geplant hat oder sich vorgestellt hat. egal wie viele steckdosen man eingeplant hat, am ende sind es immer zu wenige oder sie sind dann doch an den falschen stellen. nutzung verändert die anforderungen. und der luxus darauf ständig reagieren zu können ist (für mich) sehr befriedigend.
die to-do-liste bei kottke hat bei mir mehrere saiten klingen lassen. einerseits weil sich ein paar der ideen von ihm mit meinen decken und andererseits weil er hemmungslos grosse und kleine to-dos auf eine liste setzt. und:
some of the projects and site tweaks I most want to make aren’t even on my list. They live only in my head and I mull them over in the shower or while walking until they’re “done” enough to start working on.
egal wie doll ich versuche strukturiert zu planen und aufzuschreiben was ich mit dieser webseite machen will, ein grossteil der ideen will meinen kopf nicht verlassen bevor sie einen gewissen reifegrad erreicht haben. solange schwirren sie zuverlässig in meinem hinterkopf herum.
im folgenden ein paar der dinge die es im letzten jahr aus meinem kopf auf die webseite geschafft haben. danach ein paar dinge die es aus meinem kopf in eine liste geschafft haben.
eine dieser ideen oder eher eine der fragen die jahrelang in meinem kopf herumschwirrte war: wie gehe ich mit instagram um? einerseits find ich meta doof und verstehe instagram nicht mehr wirklich, andererseits gibt es dort immer noch einige leute die sich offensichtlich über fotos von mir freuen und sich dort gerne herumtreiben. aber weil instagram in den letzten jahren alle schotten abgedichtet hat und es unmöglich gemacht hat von dort kopien der eigenen posts für die eigene webseite zu ziehen, wurde das posten dort zu einem mühseligen manuellen prozess. bis mir irgenwann einfiel, dass man dort mit einem „pro“-account auch programatisch posten kann. seitdem schiebe ich instagram-posts einfach von meinem kirby-backend per knopfdruck an, kopiere also von hier nach da. damit bleiben erstmal alle metadaten und originale bei mir. instagram bekommt ne kopie.
genauso mache ich es mit grain, fotos oder foto-serien schiebe ich selektiv von wirres.net zu grain. grain ist übrigens einer der wenigen #ATproto-dienste, die mein interesse seit meiner kurzen euphoriephase halten konnten. den ATproto-standard-reader, in dem ich kurzzeitig einen potenziellen nachfolger des google-readers gesehen habe, finde ich nach wie vor interessant, nutze ihn aber kaum noch. auch weil er (noch) so langsam werkelt, dass es die benutzbarkeit und den bedienungsspass stark einschränkt. aber grain ist toll, so wie früher mal instagram war: leute und deren fotos, umgekehrt chronologisch sortiert. fertig.
mittlerweile bekomme ich teilweise bei grain (17 follower) genauso viele ♥️ wie auf instagram (942 follower). fürs gleiche bild. absurd. daran sieht man wie abgefuckt instagram mittlerweile ist.
roman jasiek schreibt, dass er sich gerne in viele kleine details reinsteigert, „die vermutlich kaum jemand bewusst wahrnimmt“. das geht mir auch so.

­ an den stellen die trennbar sind ausgeliefert, so dass browser dann (relativ) zuverlässig den text trennen können. das nervt zwar beim kopieren von text, weil die soft-hyphens mitkopiert werden, aber wer mich unbedingt zitieren oder teile meiner texte kopieren will, kann jederzeit auf die markdow-version wechseln.
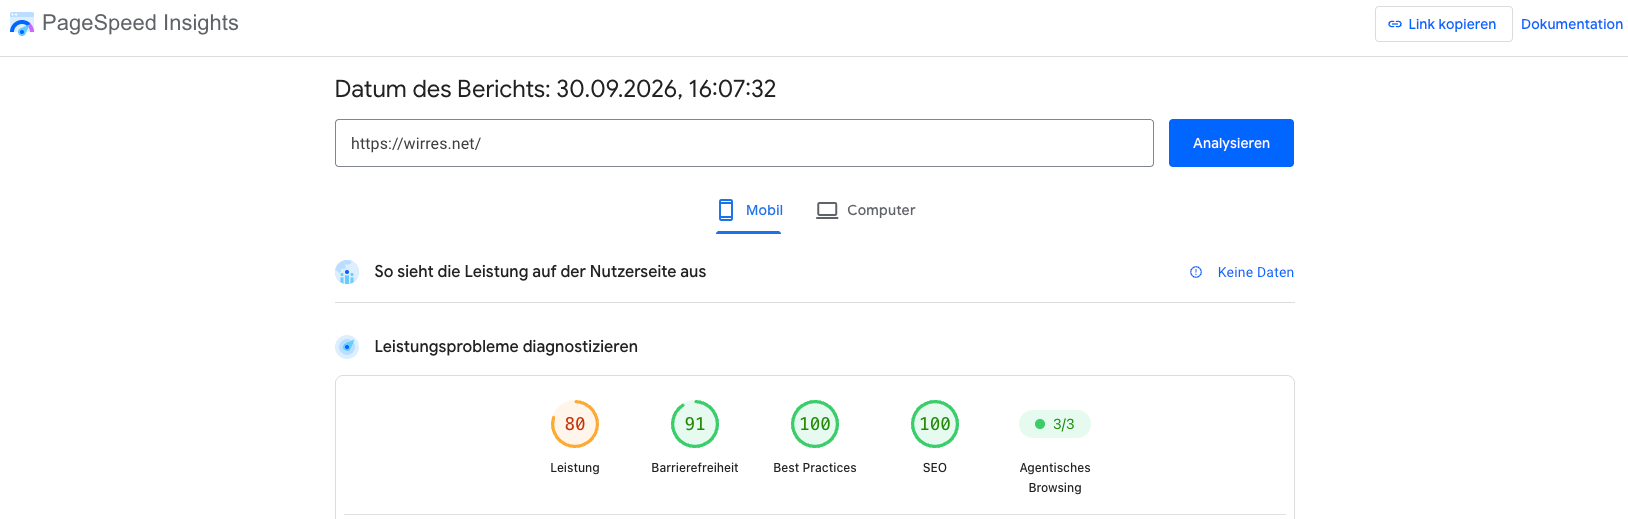
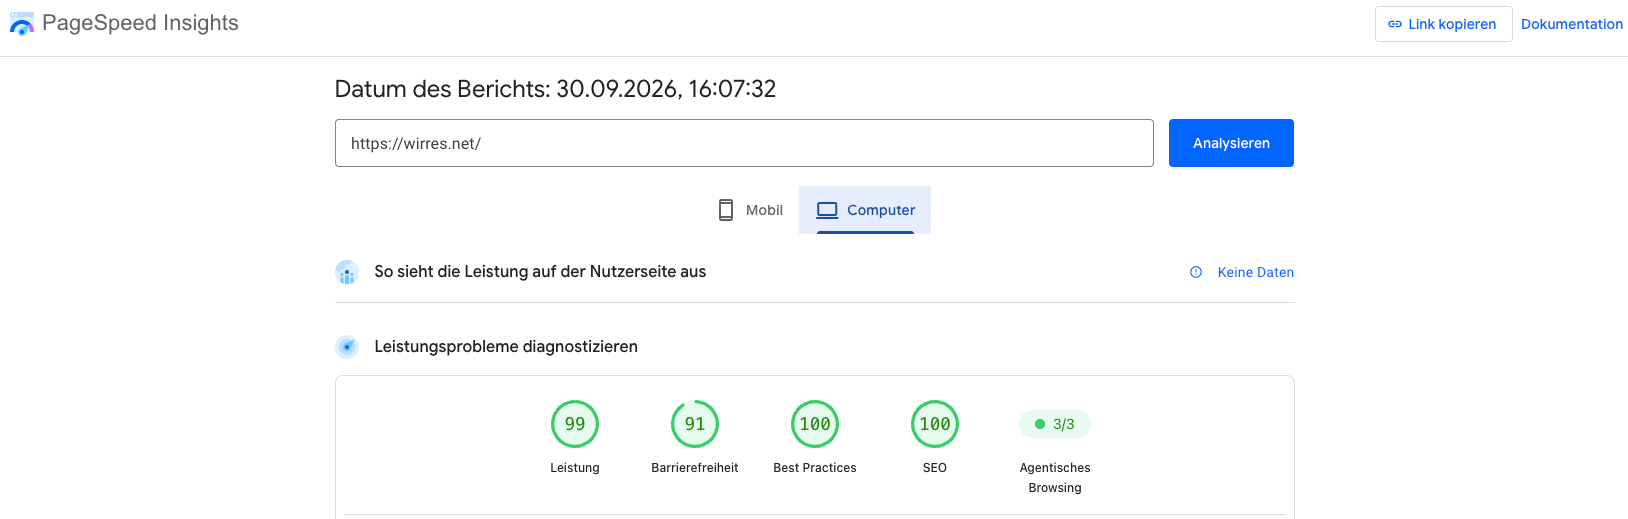
pagespeed.web.dev ist von google, aber trotzdem ein unverzichtbares werkzeug. ein paar optimierungsvorschläge schlage ich konsequent in den wind, deshalb der punktabzug bei der barrierefreiheit und im mobilen bereich. aber wenn ich an der webseite rumfummel, schleichen sich unweigerlich gelegentlich fehler ein. vieles davon entdecke ich dann mit hilfe der PageSpeed Insights. das werkzeug hält mich quasi auf dem stand der aktuellen best practices. die optimierungen die aus solchen besuchen resultieren kommen auch nicht nur google zugute, sondern jedem besuchenden, sei es eine maschine oder ein mensch.
auch das habe ich schon öfter geschrieben, aber es ist und bleibt eins meiner lieblingsthemen: optimierung auf maschinenlesbarkeit. auch hier ist meine motivation nicht primär eine optimierung für google, sondern eben für alle. wer eins meiner rezepte in eine rezeptverwaltung wirft, sollte ein gutes resultat bekommen. wer will kann die rezepte sogar in mela abonnieren. bing, kagi, perplexity können alle auf die strukturierten daten zugreifen die ich hier an meine beiträge hänge. aber soweit ich das mitbekomme, macht derzeit eigentlich nur google davon gebrauch. ich mag was dabei teilweise rauskommt.
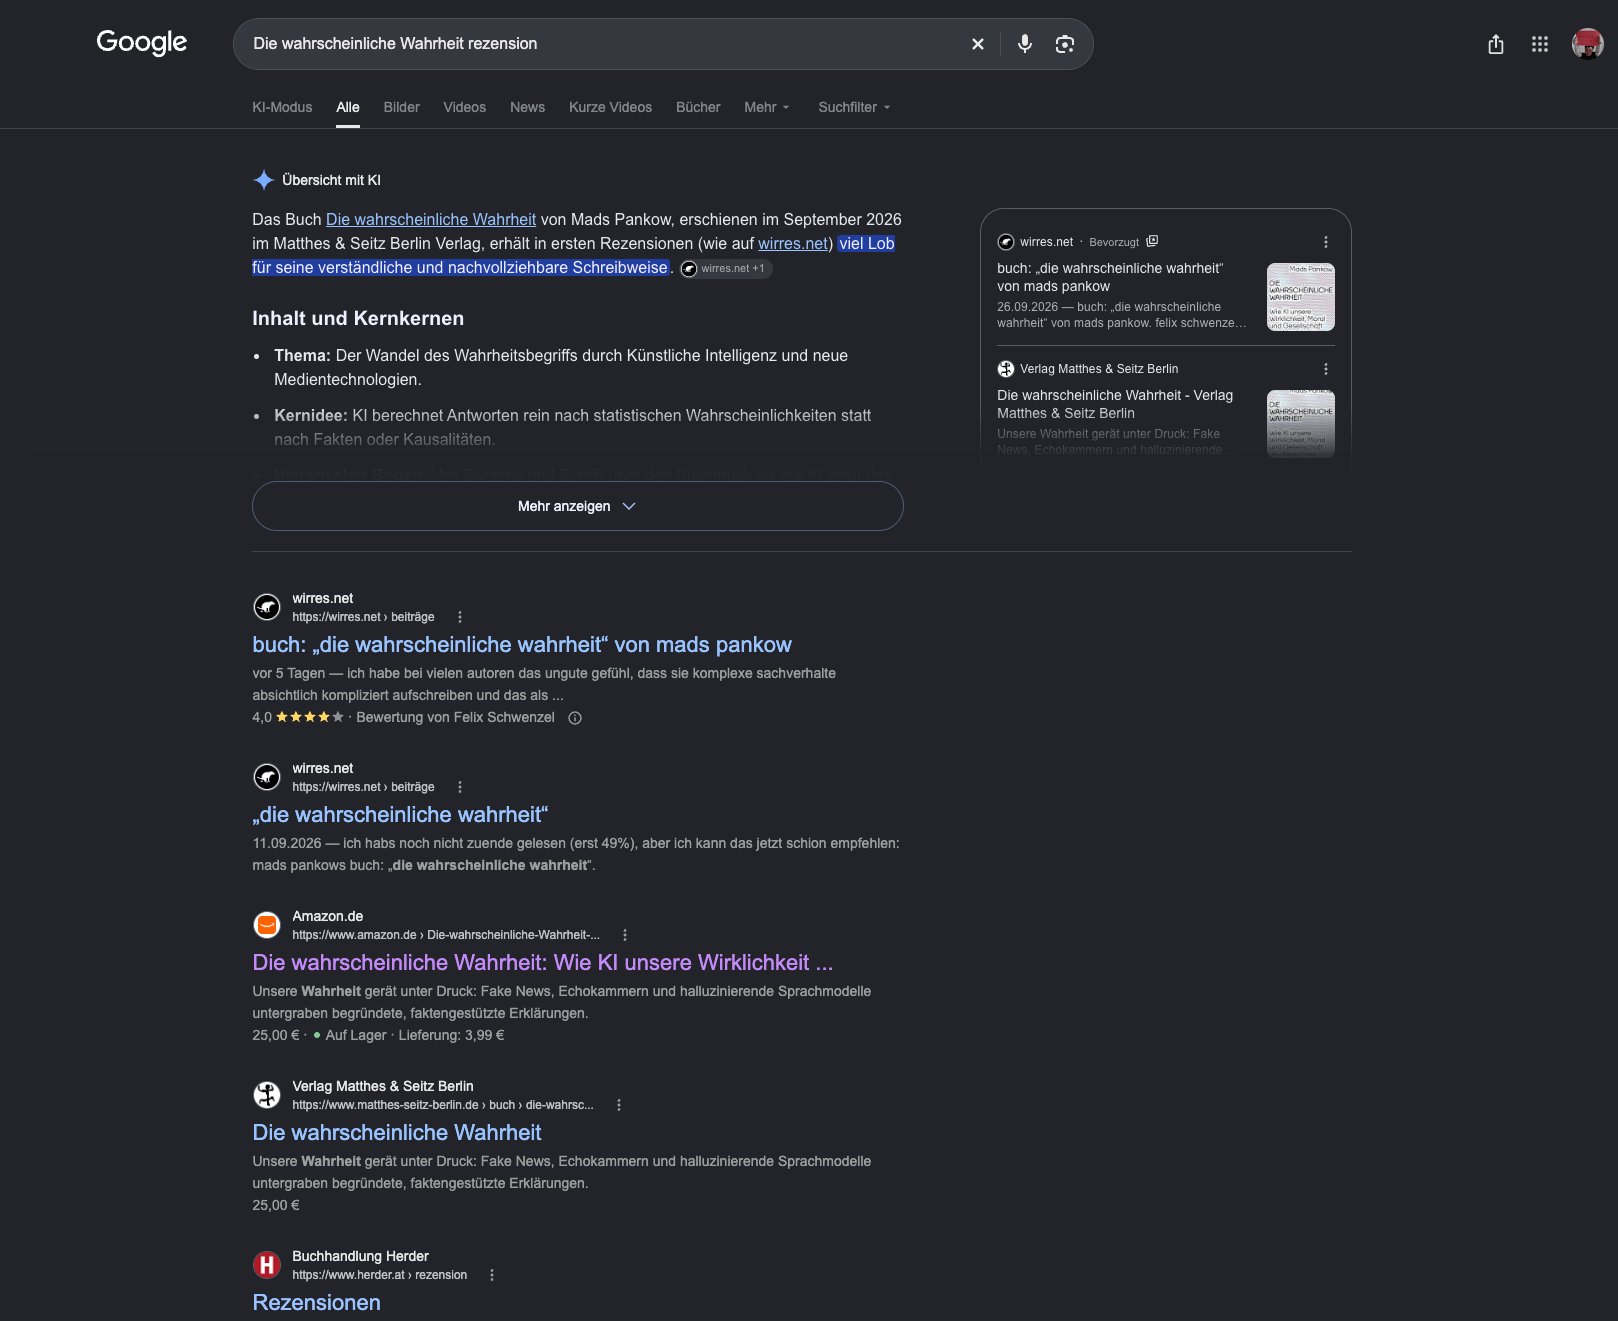
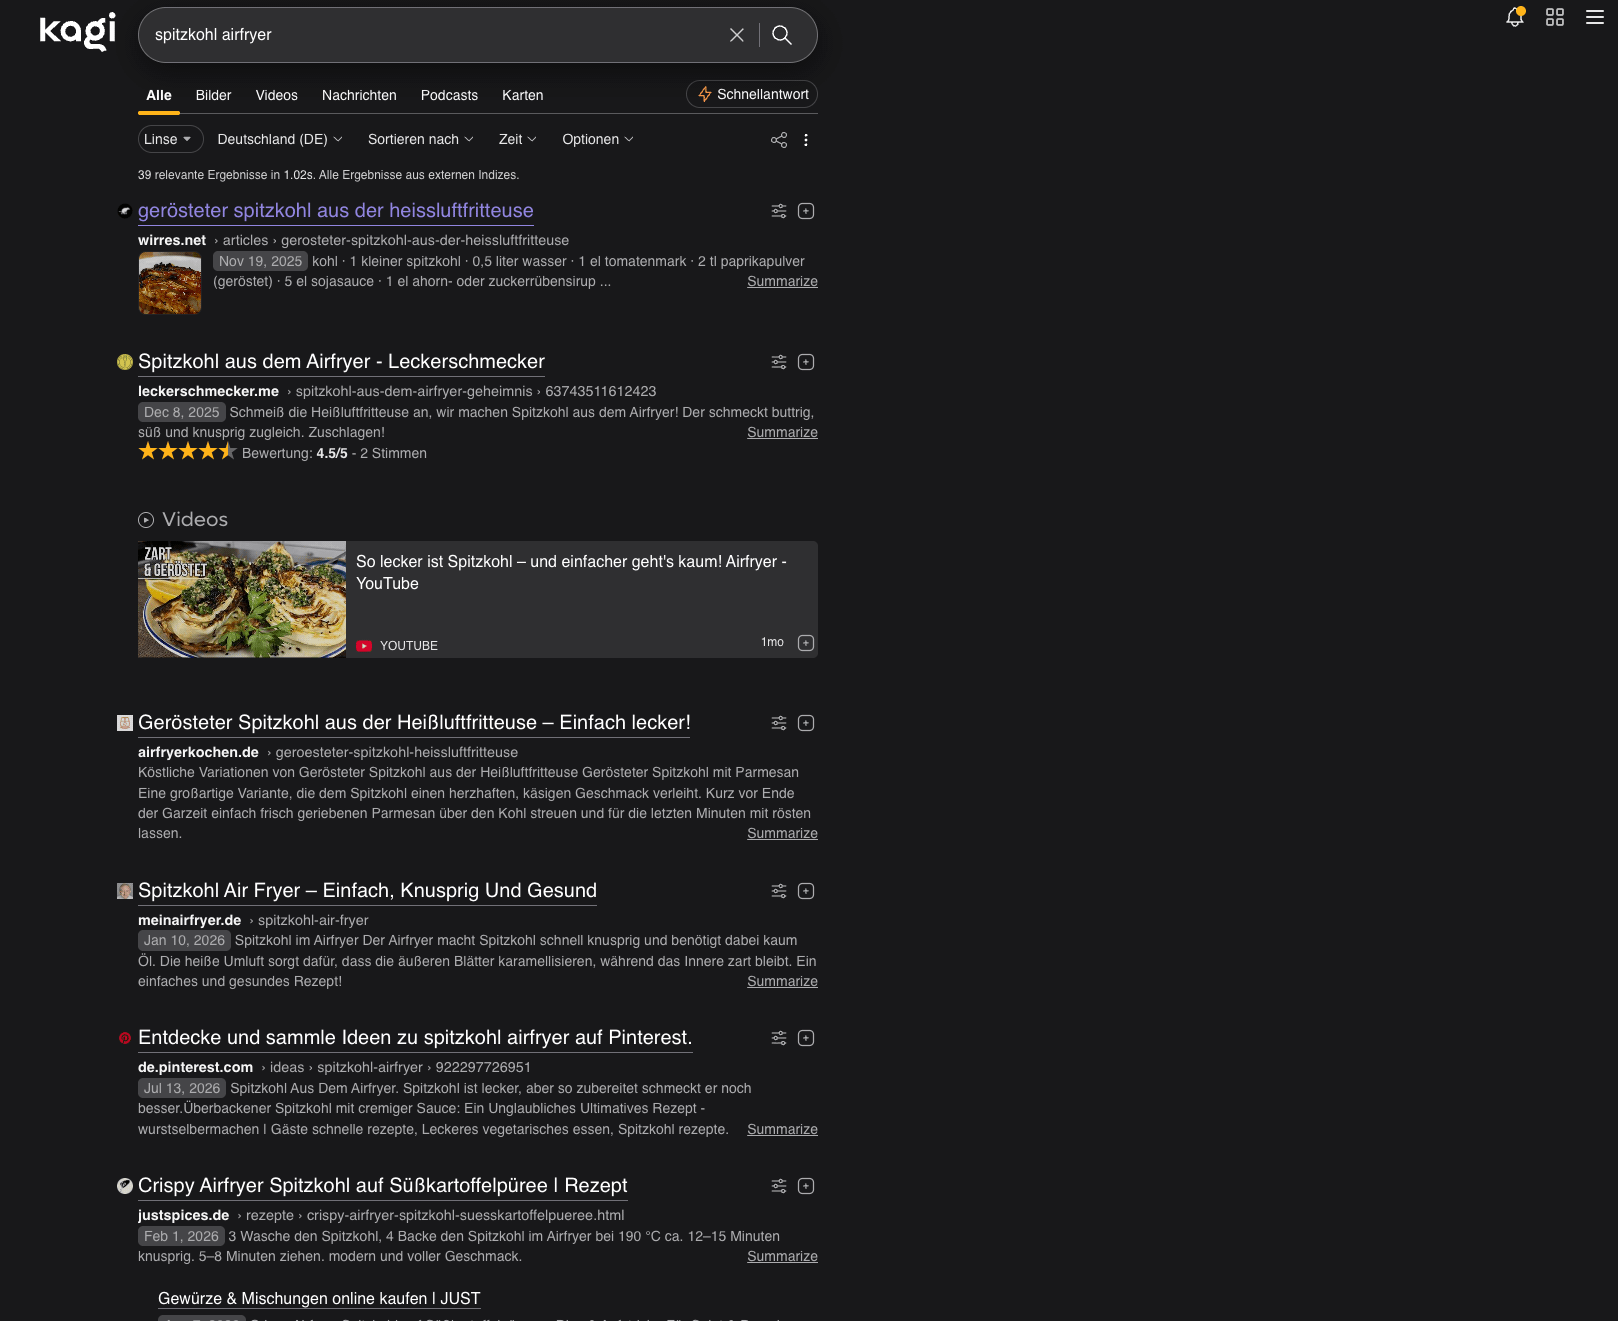
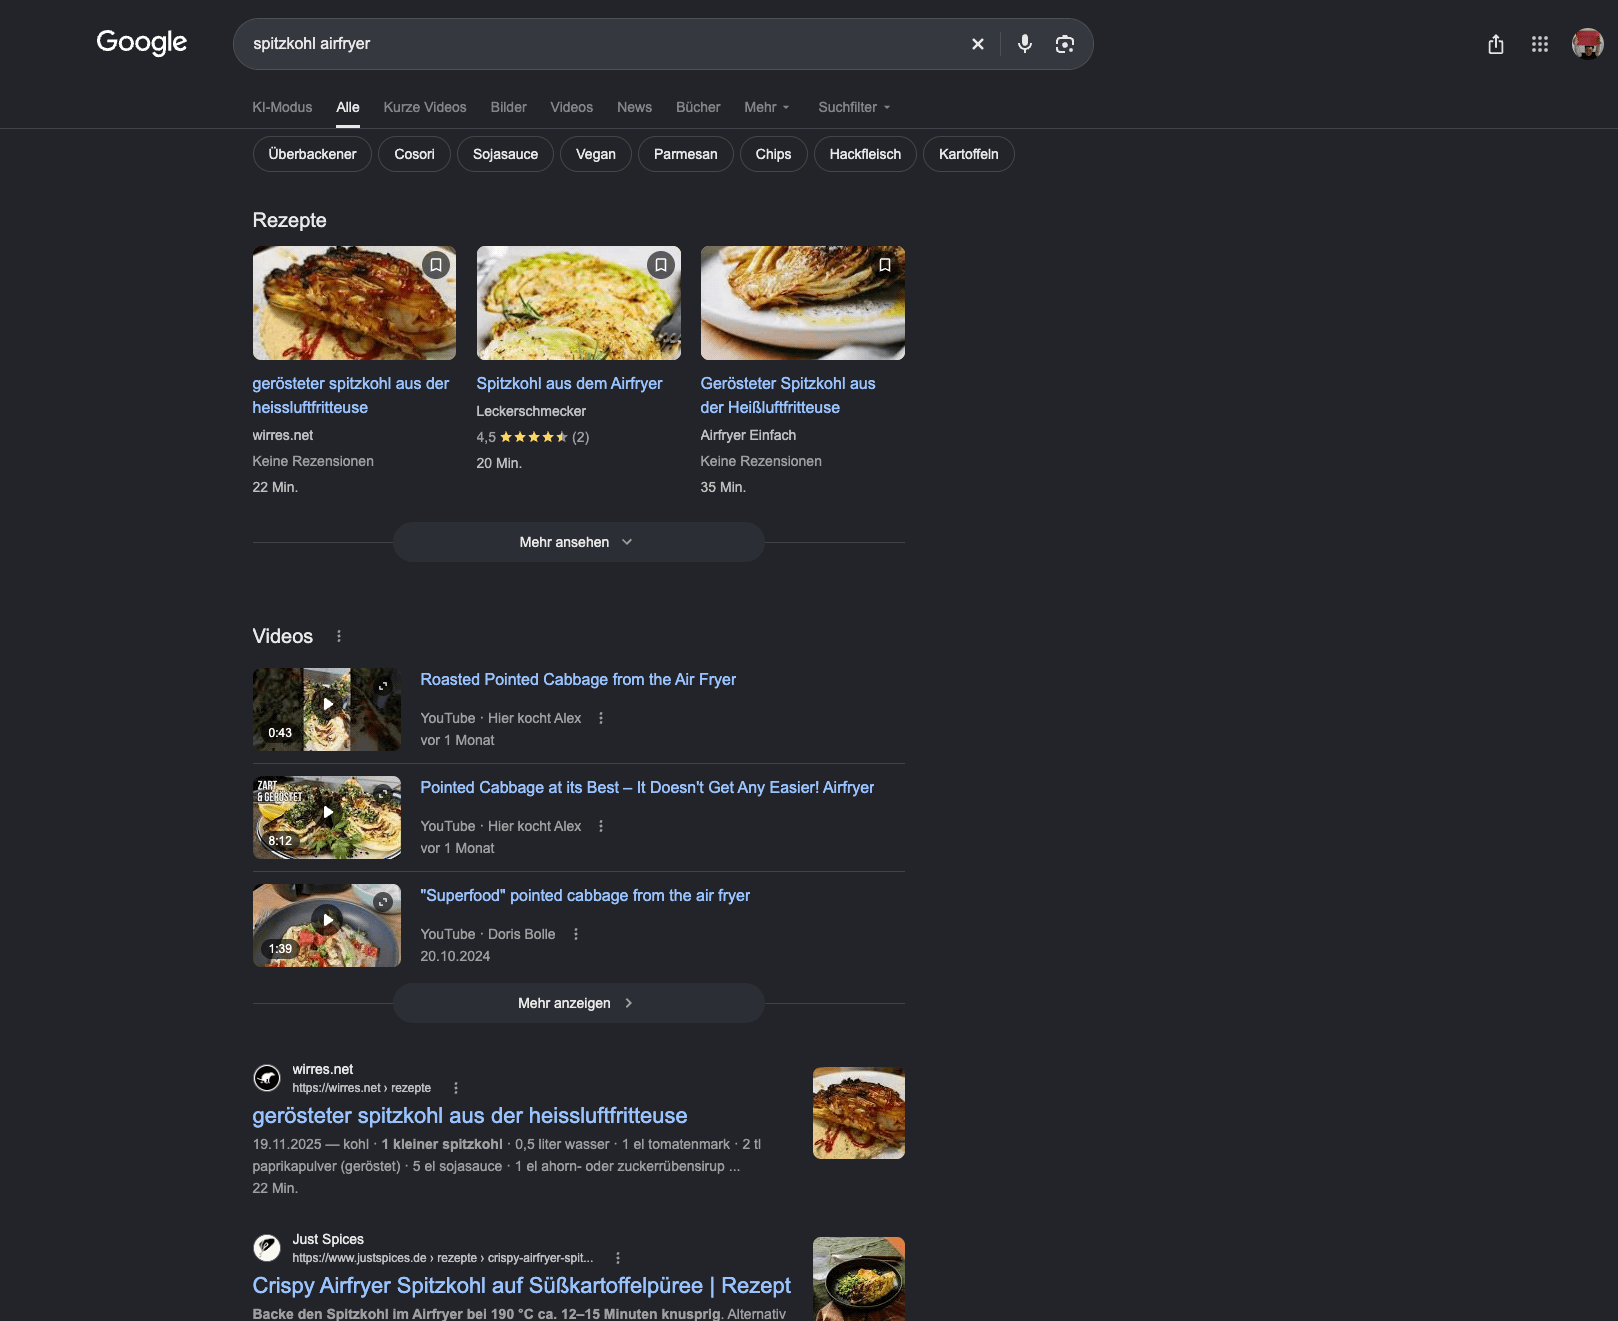
zur optimierung gehört auch darauf zu achten, dass die seite auch ohne css und js funktioniert. das kontrolliere ich auch gelegentlich und versuche die gröbsten fehler wegzuoptimieren, wenn ich welche finde. das würdevolle kaputtgehen oder in webdev-sprech: „graceful degradation“ ist eine der wichtigsten lektionen aus meinem architekturstudium und dem rumwüten in webdesgn-sphären. auch in meiner schreiner ausbildung versuchte ich so zu bauen, dass meine arbeiten auch nach einem einen schlag mit nem hammer noch gut aussehen. mauerwerk altert würdiger als vorhangfassaden, ein massivholztisch würdiger als ein spanplatten-tisch mit dünnen, aufgeleimten furnierkanten. die liste kann man unendlich weiterführen: putz / tapete, geöltes holz / lackiertes holz, parkett / laminat, terrazzo / laminat, verschraubt / verklebt, …
* [ ]) im frontend korrekt rendern.#). sieht vielleicht komisch aus und niemand weiss wozu es dient, gehört aber auf die to-do-liste.… wird fortgesetzt und ergänzt.
heute ein bisschen planlos in meiner website rumgeklickt und mich dabei gefragt, was der unterschied zwischen den kategorien „ix über wirres“ und „über wirres“ sein könnte. meine entscheidungen von vor zehn, drei jahren, manchmal auch die von vor zehn oder zwei tagen, sind für mich selbst nicht immer klar nachvollziehbar. die antwort lautet wahrscheinlich, dass ich die kategorie „ix über wirres“ in die andere überführen sollte. jedenfalls bin ich dann wieder auf den elf jahre alten artikel mit dem titel „20 jahre ins internet linken“ gelandet und von dort auf den artikel „Wie ich das Bloggen erfand“ von tim cole. dort beschreibt tim cole, wie er 1995 anfing zu bloggen.
unter dem beitrag stand ein kommentar von benedikt koehler, der damals metaroll.de betrieb und dort unter anderem eine „Geschichte der deutschen Blogoshäre“ als zeitstrahl pflegte. die originaladresse der seite ergibt schon lange 404, die kopie auf archive.org funktioniert wegen javascript-fehlern nicht mehr.
also dachte ich mir: „schade!“ und ob ich das nicht mal schnell rüberkopieren könnte und wieder zum laufen bringen könnte. mit etwas hilfe ging das ganz schnell, auch die alte SIMILE javascript-bibliothek, die den zeitstrahl baut, funktionierte noch:
wirres.net/html/metaroll.de/bloghistory.html
dann fragte ich mich, ob vielleicht ne modernere bibliothek zur darstellung eines zeitstrahls gibt und die gibts offensichtlich mit vis-timeline:
wirres.net/html/metaroll.de/bloghistory-vis.html
die bloghistory quelldatei die benedikt koehler damals zusammengetragen hat habe ich unverändert gelassen, ausser dass ich zwei einträge hinzugefügt und einen verschoben habe:
dann habe ich ein bisschen auf dem zeitstrahl rumgeklickt und war einerseits nicht überrascht, wie viele der blogs verstorben sind und andererseits doch überrascht.
über die frühe version von industrial technology & witchcraft, dann auf eine spätere version von industrial technology & witchcraft gelangt und dort diese perle von heinz erhard via nippeshexchen von majo transkribiert:
Der Fischer
Das Meer ist angefüllt mit Wasser
und unten ist’s besonders tief,
am Strande dieses Meeres sass er,
d.h. er lag, weil er ja schlief.Und nochmal: Am Meere sass er,
d.h. er lag, weil er ja schlief,
und in dem Meer war sehr viel Wasser
und unten war’s besonders tief.Da plötzlich teilten sich die Fluten
und eine Jungfrau kam herfür,
auf einer Flöte tat sie tuten,
das war kein schöner Zug von ihr.Dem Fischer ging das Lied zu Herzen,
obwohl sie falsche Töne pfoff ---
man sah ihn in das Wasser sterzen,
dann ging er unter und ersoff.
ich ab mich dann allerdings gefragt, ob erhardt wirklich „d.h.“ und „---“ verwendet haben könnte und googelte/sterzte dem gedicht nach, bis ich einen (relativ neuen) abdruck in buchform (seite 24) fand. also nochmal neu setzen:
Der Fischer
(Frei nach Johann Sebastian Goethe)
Das Meer ist angefüllt mit Wasser
und unten ist’s besonders tief,
am Strande dieses Meeres saß er,
d. h., er lag, weil er ja schlief.
Und nun noch mal: Am Meere saß er,
d. h., er lag, weil er ja schlief,
und in dem Meer war sehr viel Wasser
und unten war’s besonders tief.Da plötzlich teilten sich die Fluten
und eine Jungfrau kam herfür,
auf einer Flöte tat sie tuten,
das war kein schöner Zug von ihr.
Dem Fischer ging das Lied zu Herzen,
obwohl sie falsche Töne pfoff – – –
man sah ihn in das Wasser sterzen,
dann ging er unter und ersoff.
für den morgenspaziergang sind frida und ich heute mit der sbahn nach frohnau gefahren und von dort durch frohnau und den tegeler forst zurück nach tegel gelaufen.
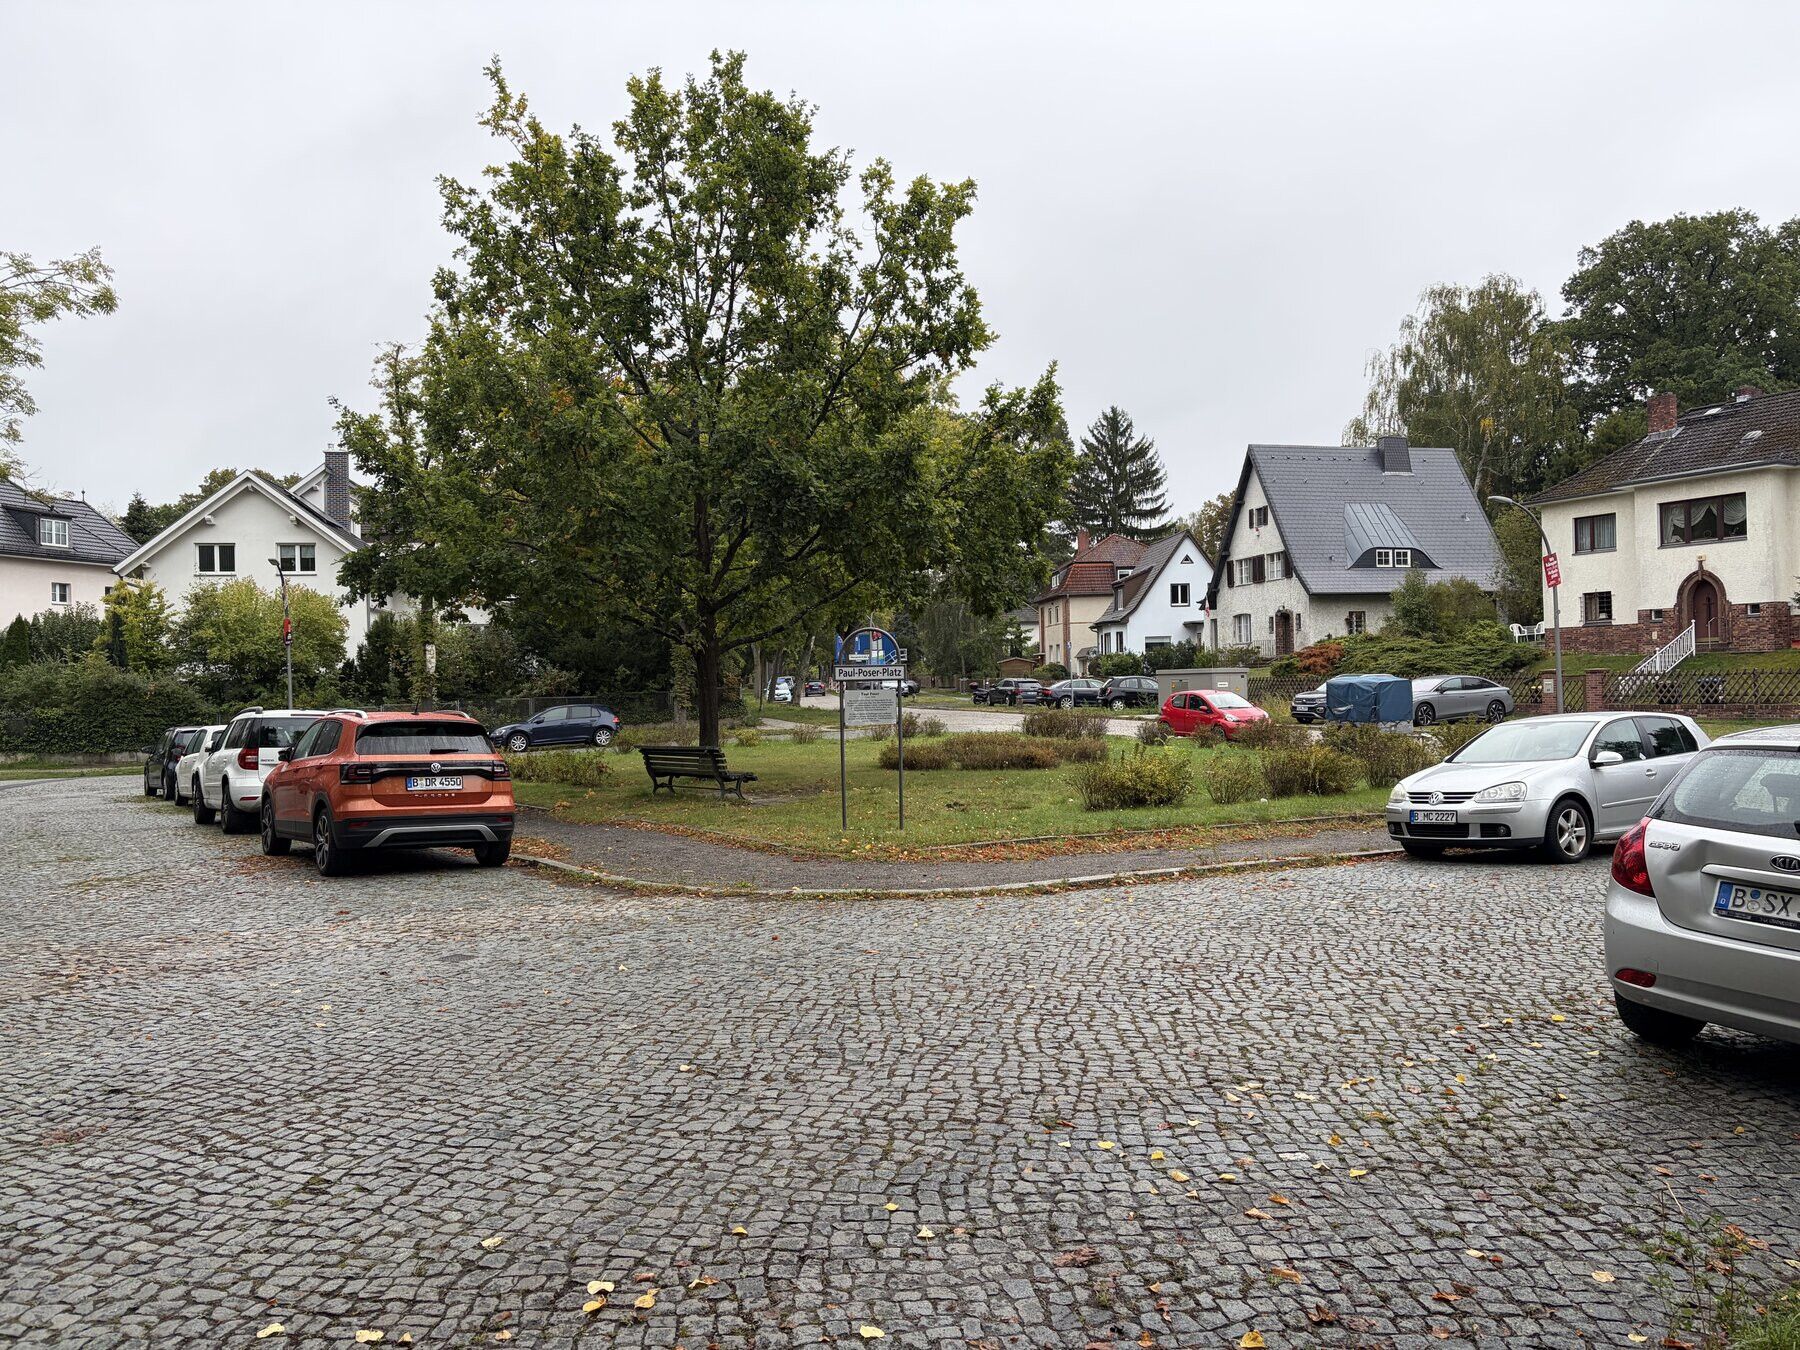
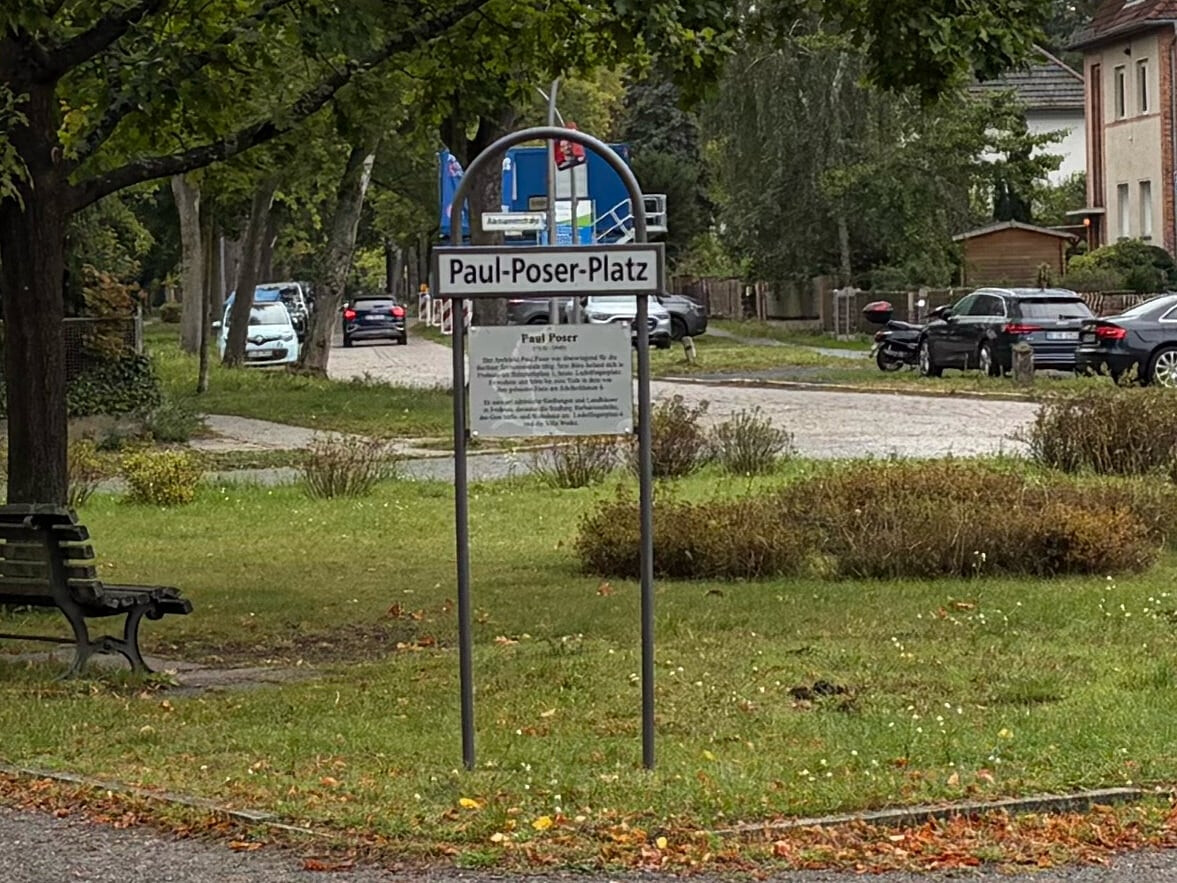
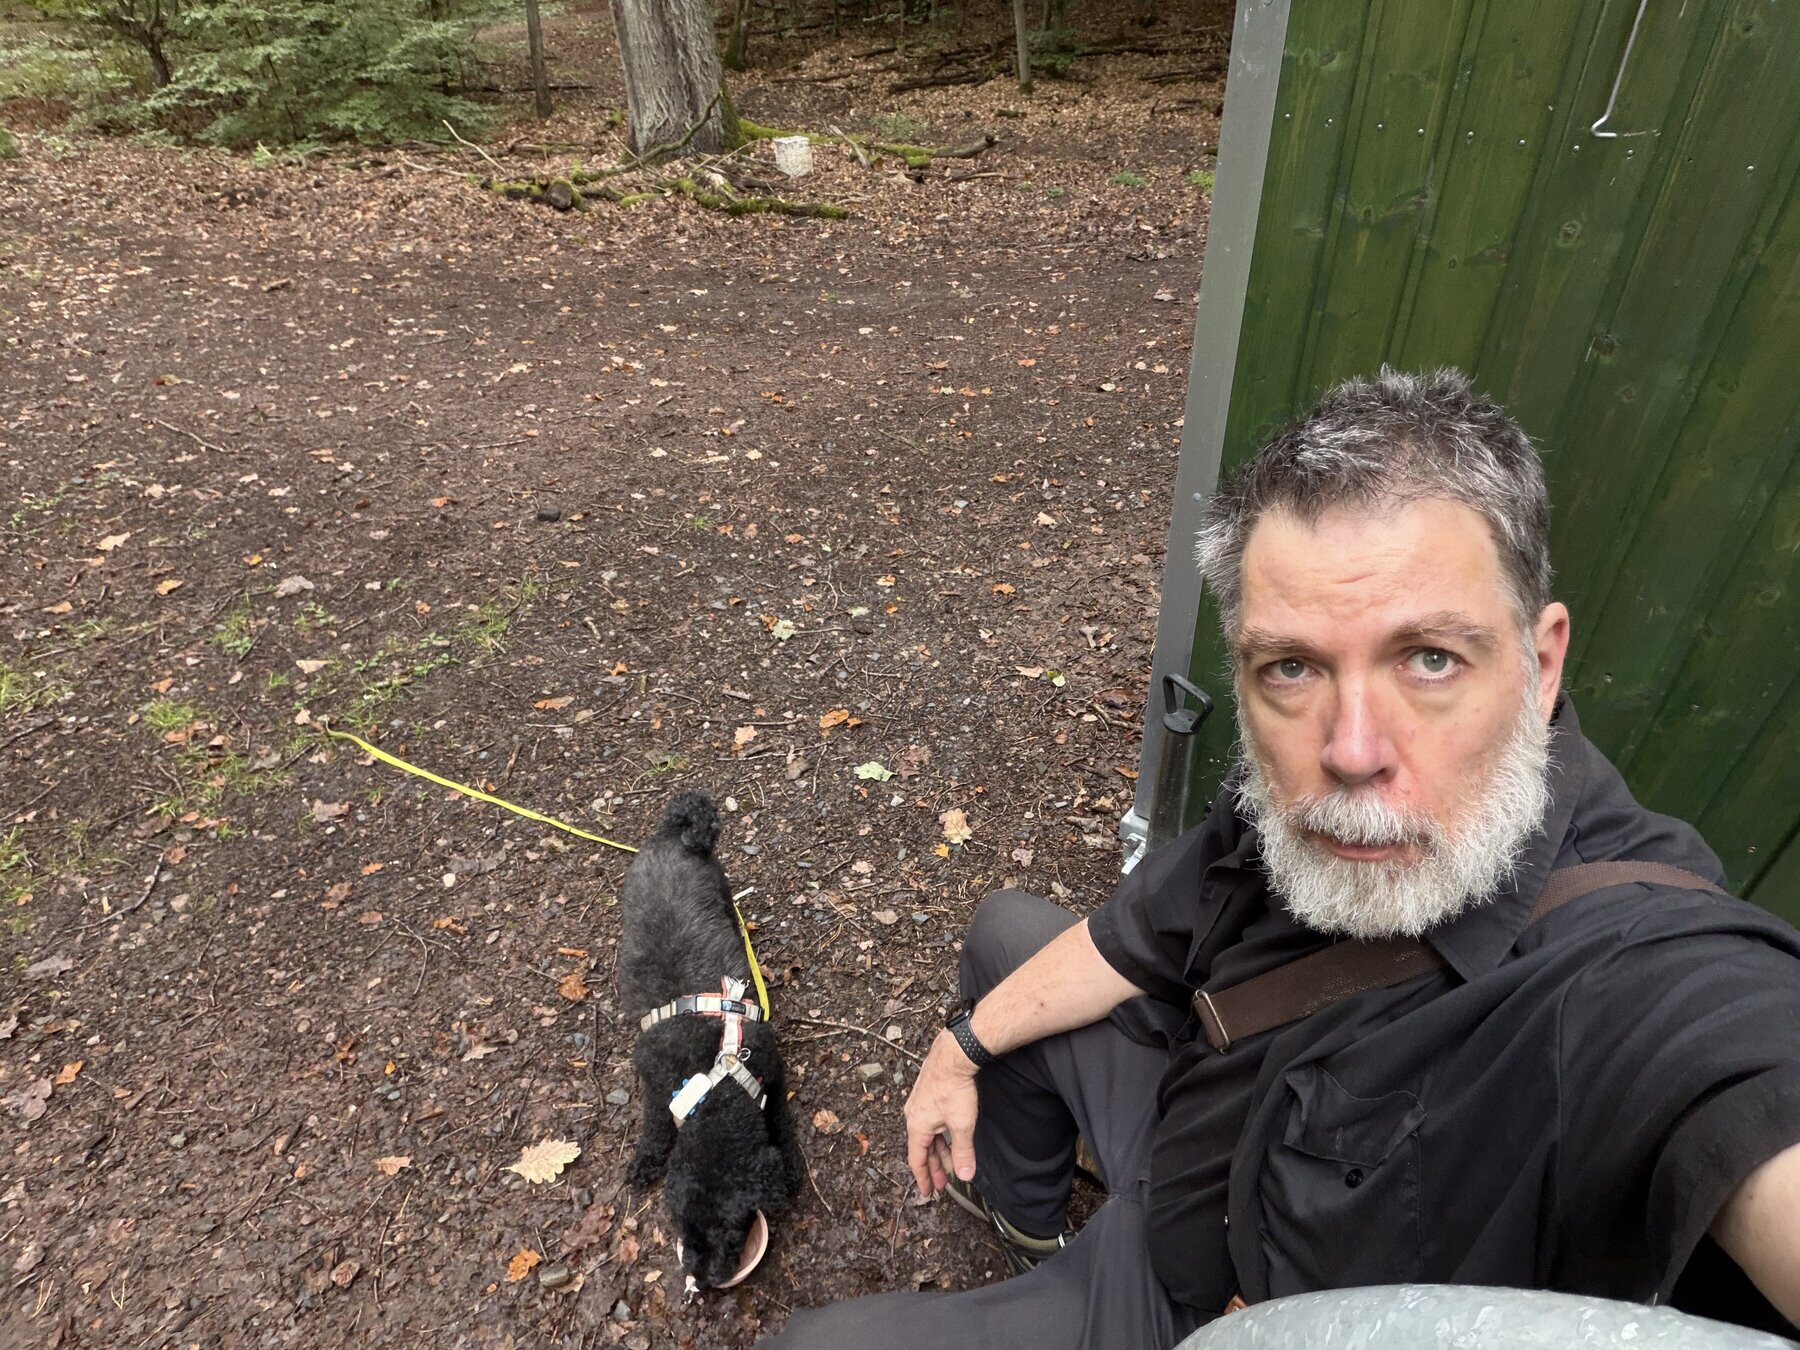
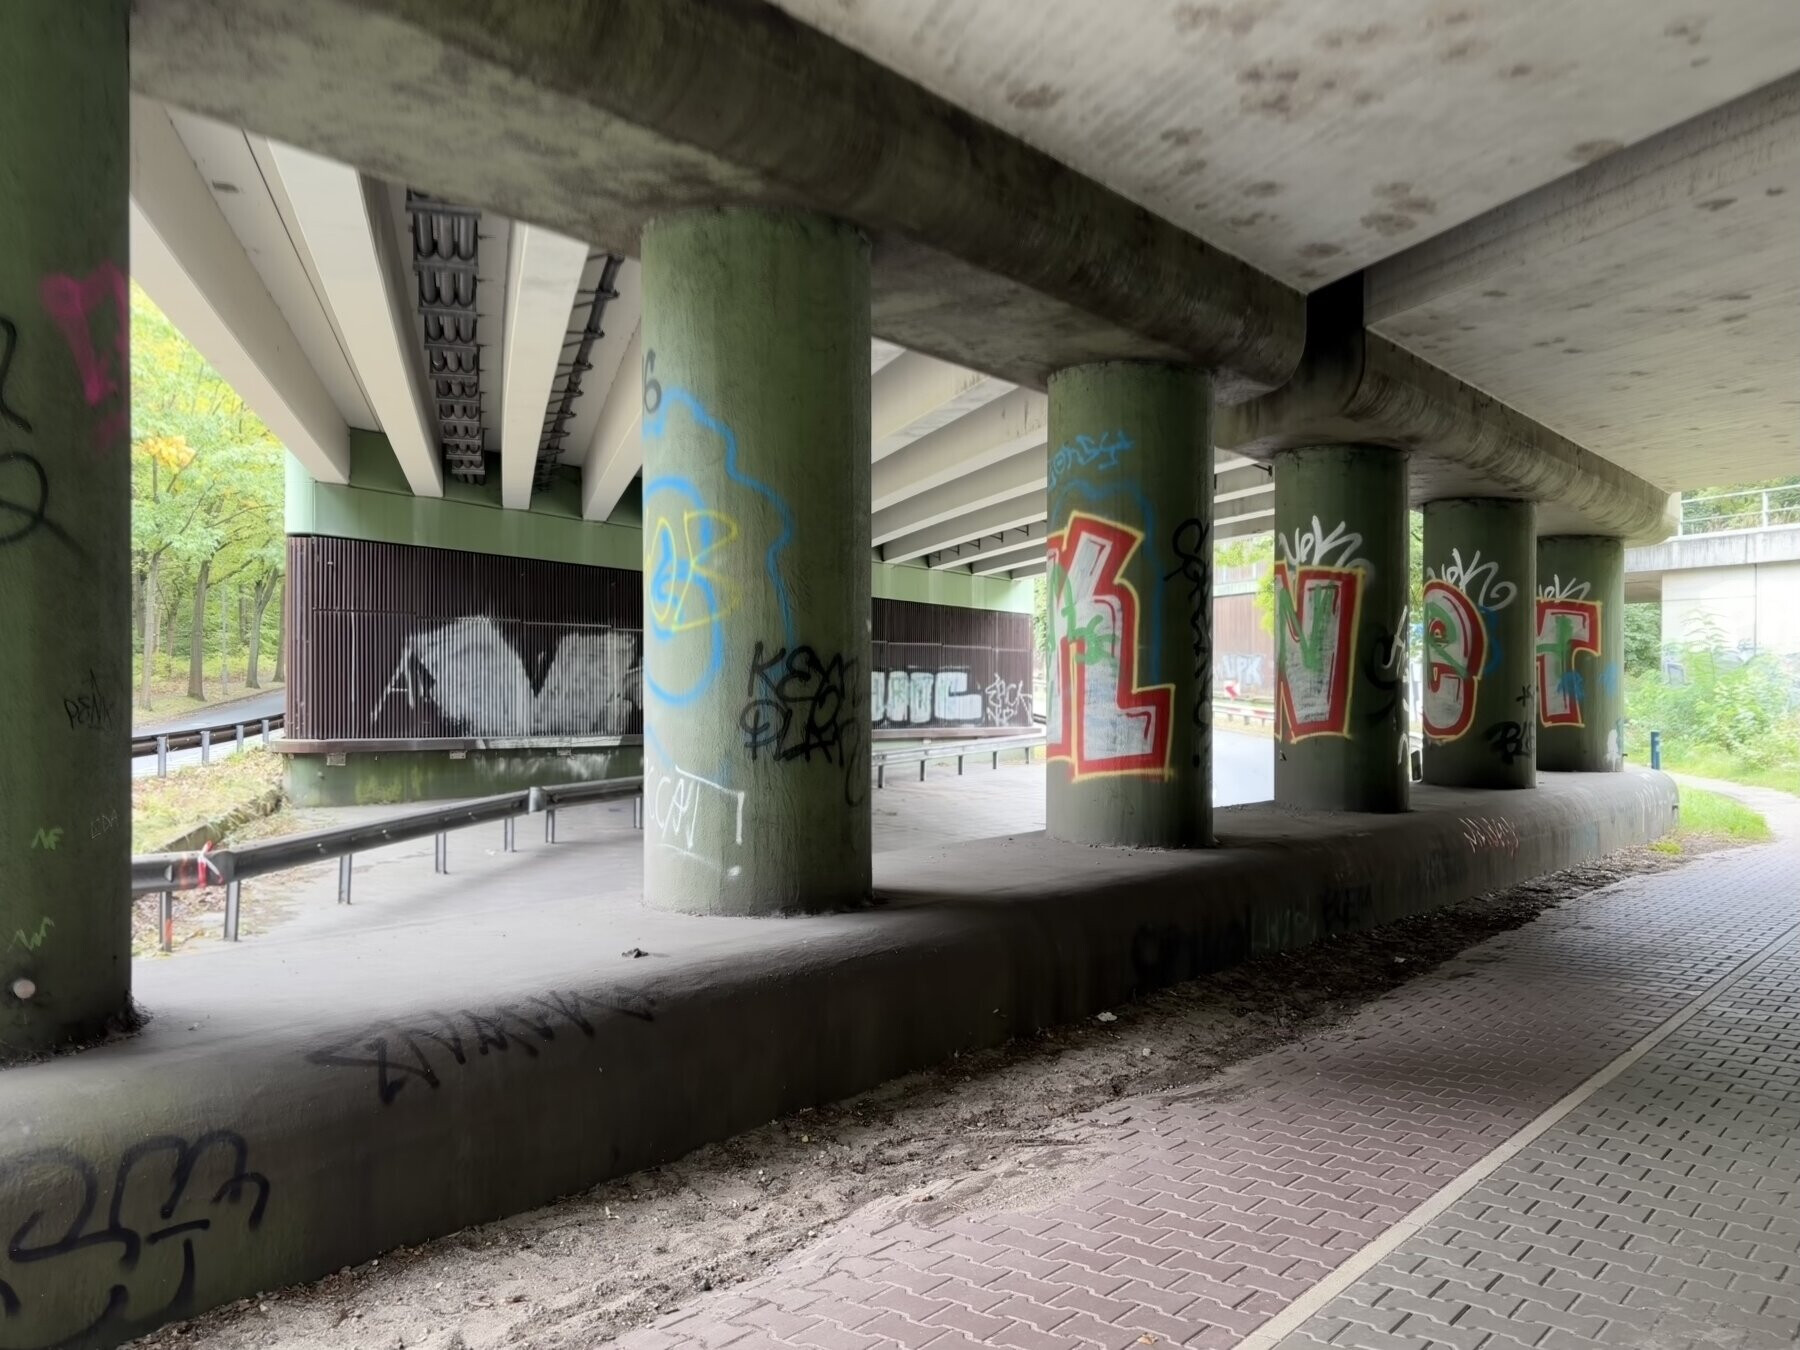
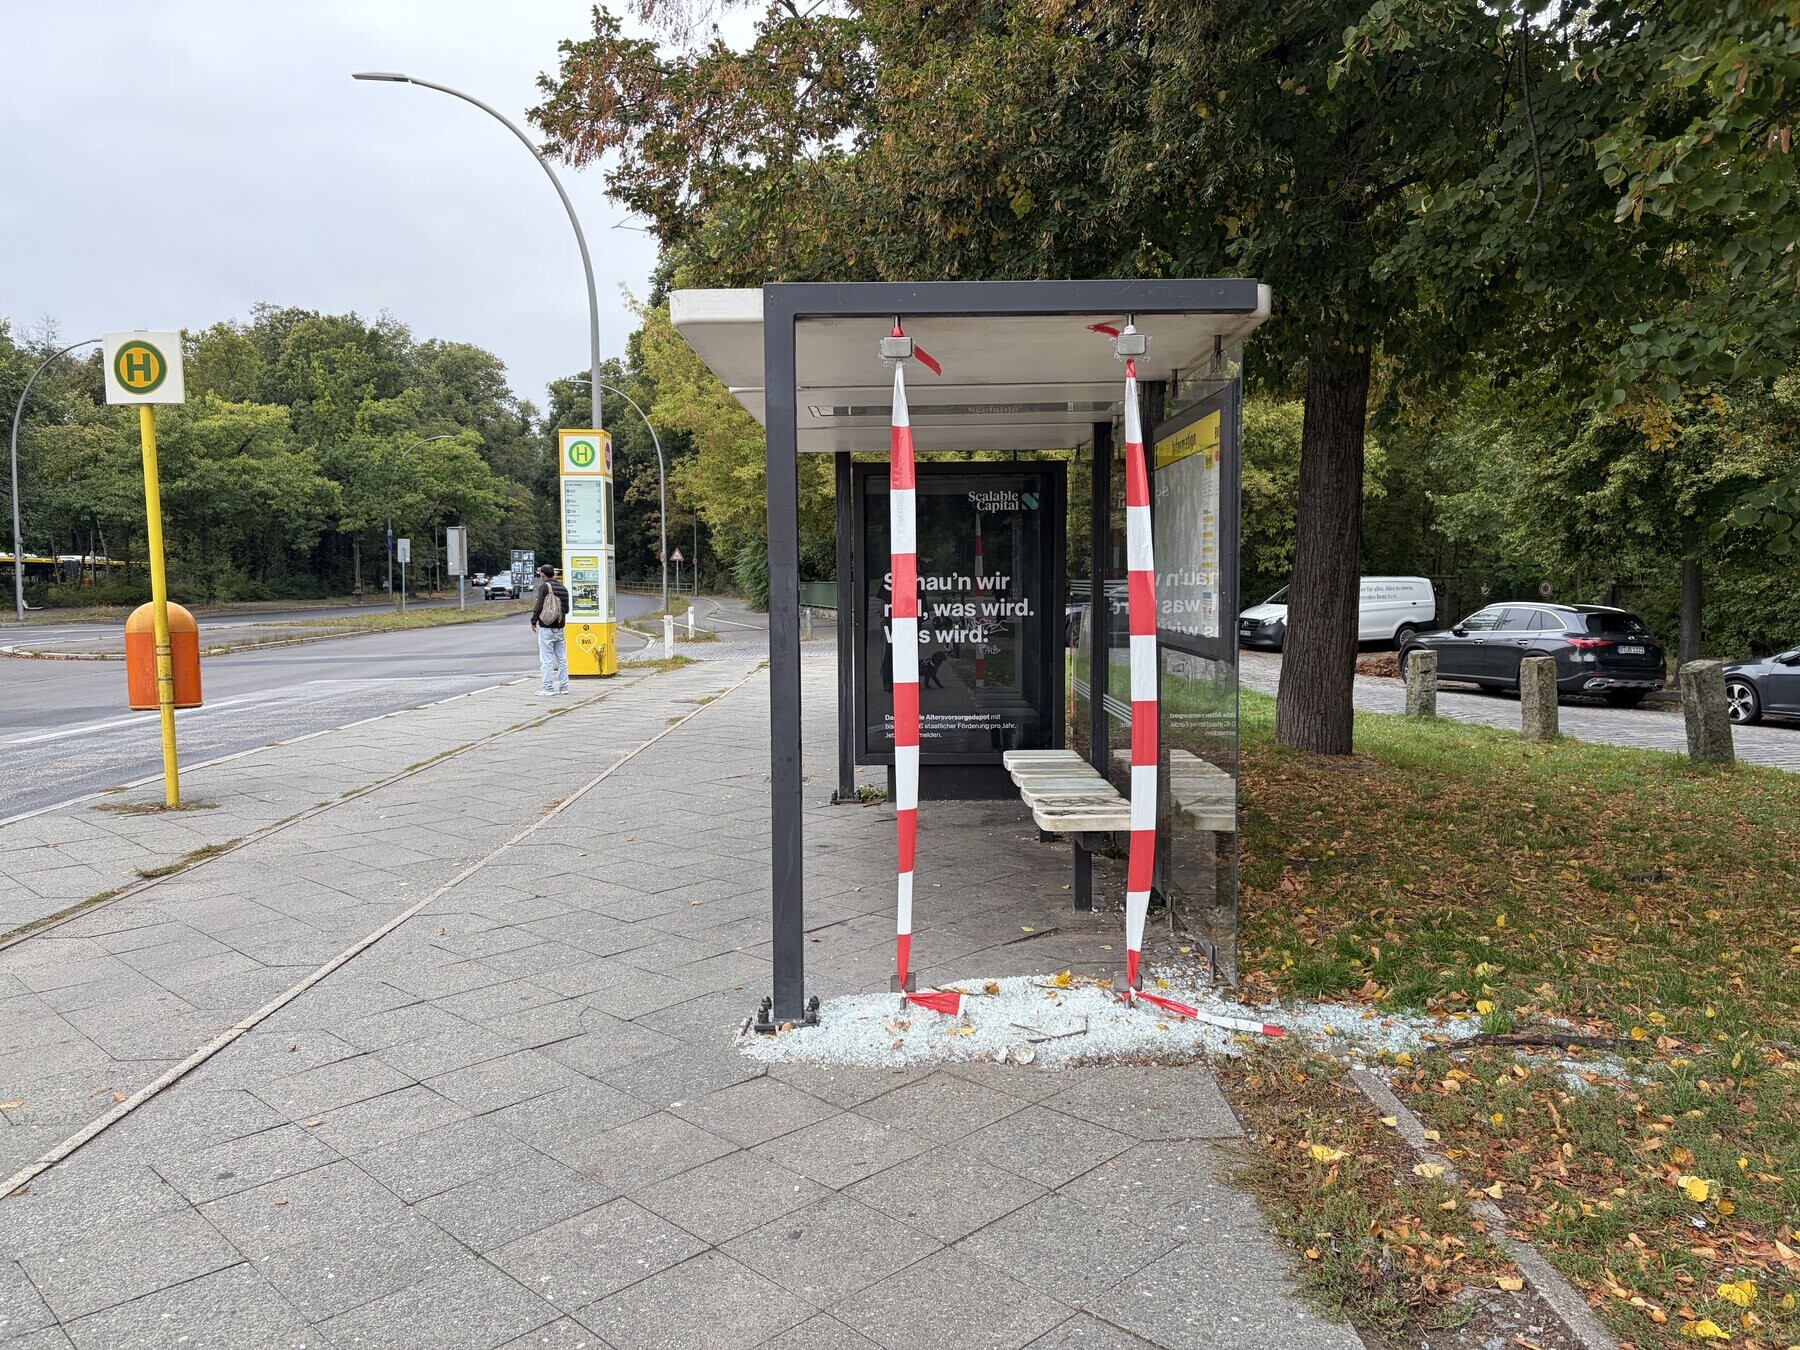
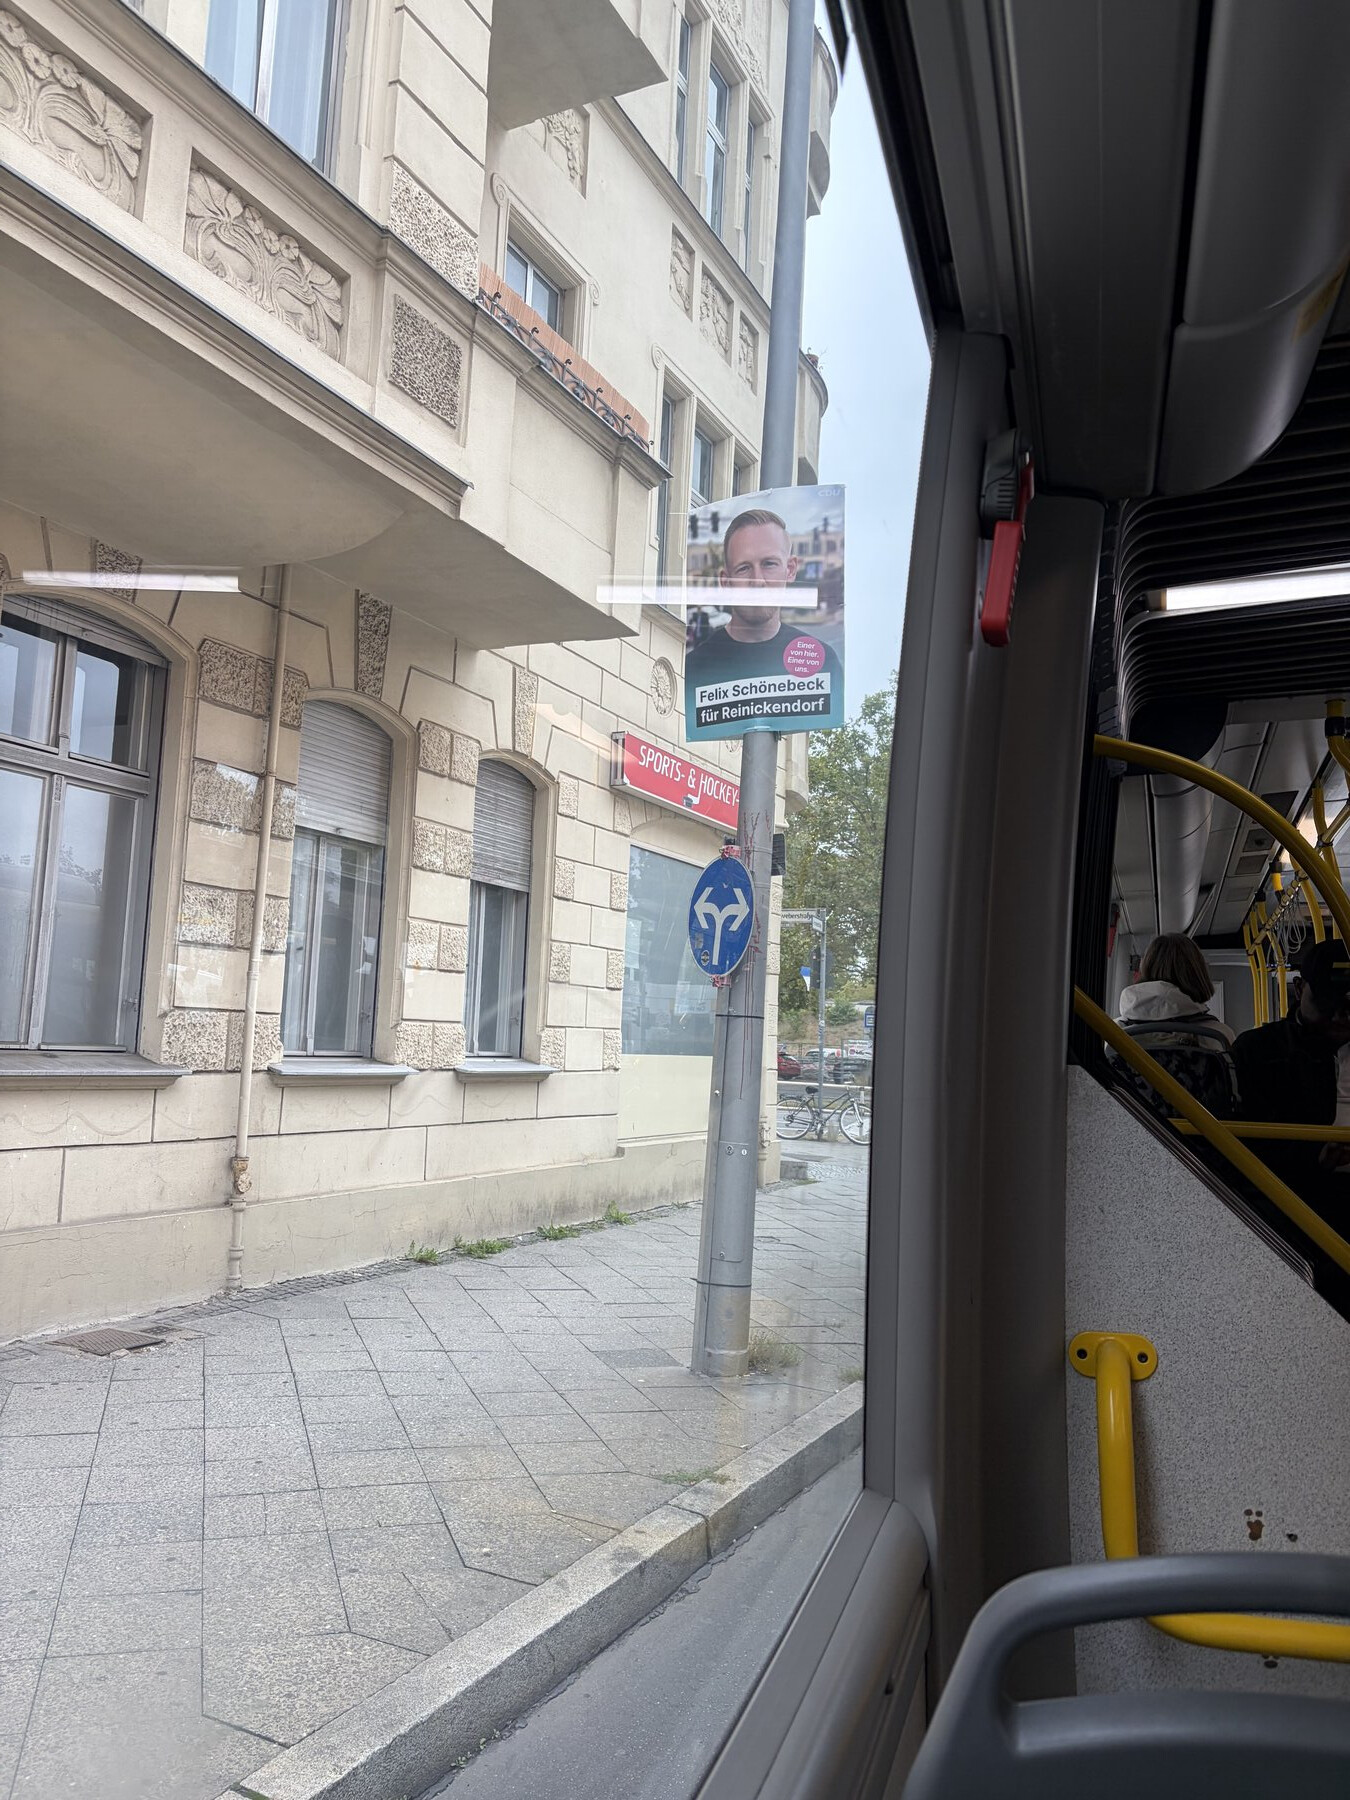
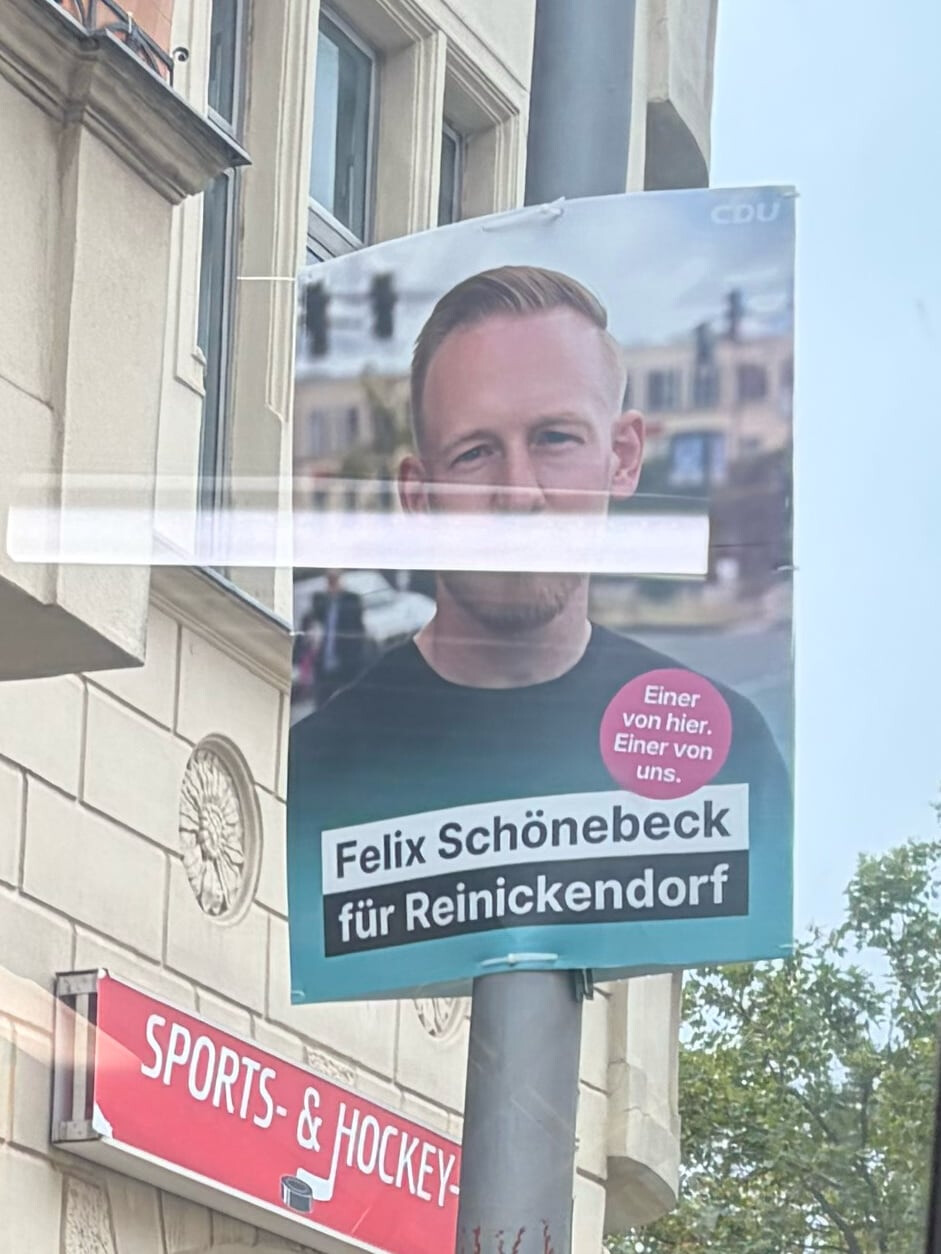
die apple watch hat insgesamt 8,8 km und fast 10.000 schritte aufgezeichnet, nach dem spaziergang hat frida bis 16:30 geschlafen. ich vermute es ist für sie um ein vielfaches anstrengender an der kurzen leine zu gehen als im freilauf zu schnüffeln, zu stöbern und jägerin zu spielen. wenn sie wie heute im wald durchgehend an der kurzen leine ist und sich auf mich konzentrieren muss, dürfte das sehr anstrengend sein. auf der rückfahrt im bus an einem wahlkampfplakat vorbeigekommen das zwar als CDU plakat zu erkennen war, aber sich trotzdem das CDU-logo sparte, bzw. das mit 80% transparenz in der oberen, rechten ecke versteckte.
mir ist aufgefallen1, dass ich den html-tag <kbd> noch nie richtig gestyled hatte. das habe ich jetzt nachgeholt und kann über die tastaturkürzel, die auf wirres.net funktionieren, schreiben.
was ich ständig selbst benutze, ist die taste y. die klappt das navigationsmenü rechts auf, egal wo ich mich auf der seite befinde. was ich auch ständig selbst benutze, ist j/k. auf artikelseiten navigiert man damit zum vorherigen / nächsten artikel, auf übersichtsseiten scrollt man damit von einem beitrag zum nächsten.
eine übersicht der tastaturkürzel bekommt man mit ?, und mit x klappt man artikel temporär zu (was übersichtsseiten manchmal übersichtlicher macht).
(konami code ist nicht implementiert. der funktioniert aber auf bubbles.)
an den html-tag <kbd> hat mich dieser markdown-editor erinnert. den nutze ich zwar nicht, aber in den letzten tagen habe ich sehr oft das paste-to-markdown-feature auf der gleichen seite genutzt. das ist enorm hilfreich, wenn man formatierten text (mit formatierung oder links) mal eben schnell in markdown wandeln will, was ich bei der rekonstruktion meiner alten piqs sehr viel getan habe. ↑︎
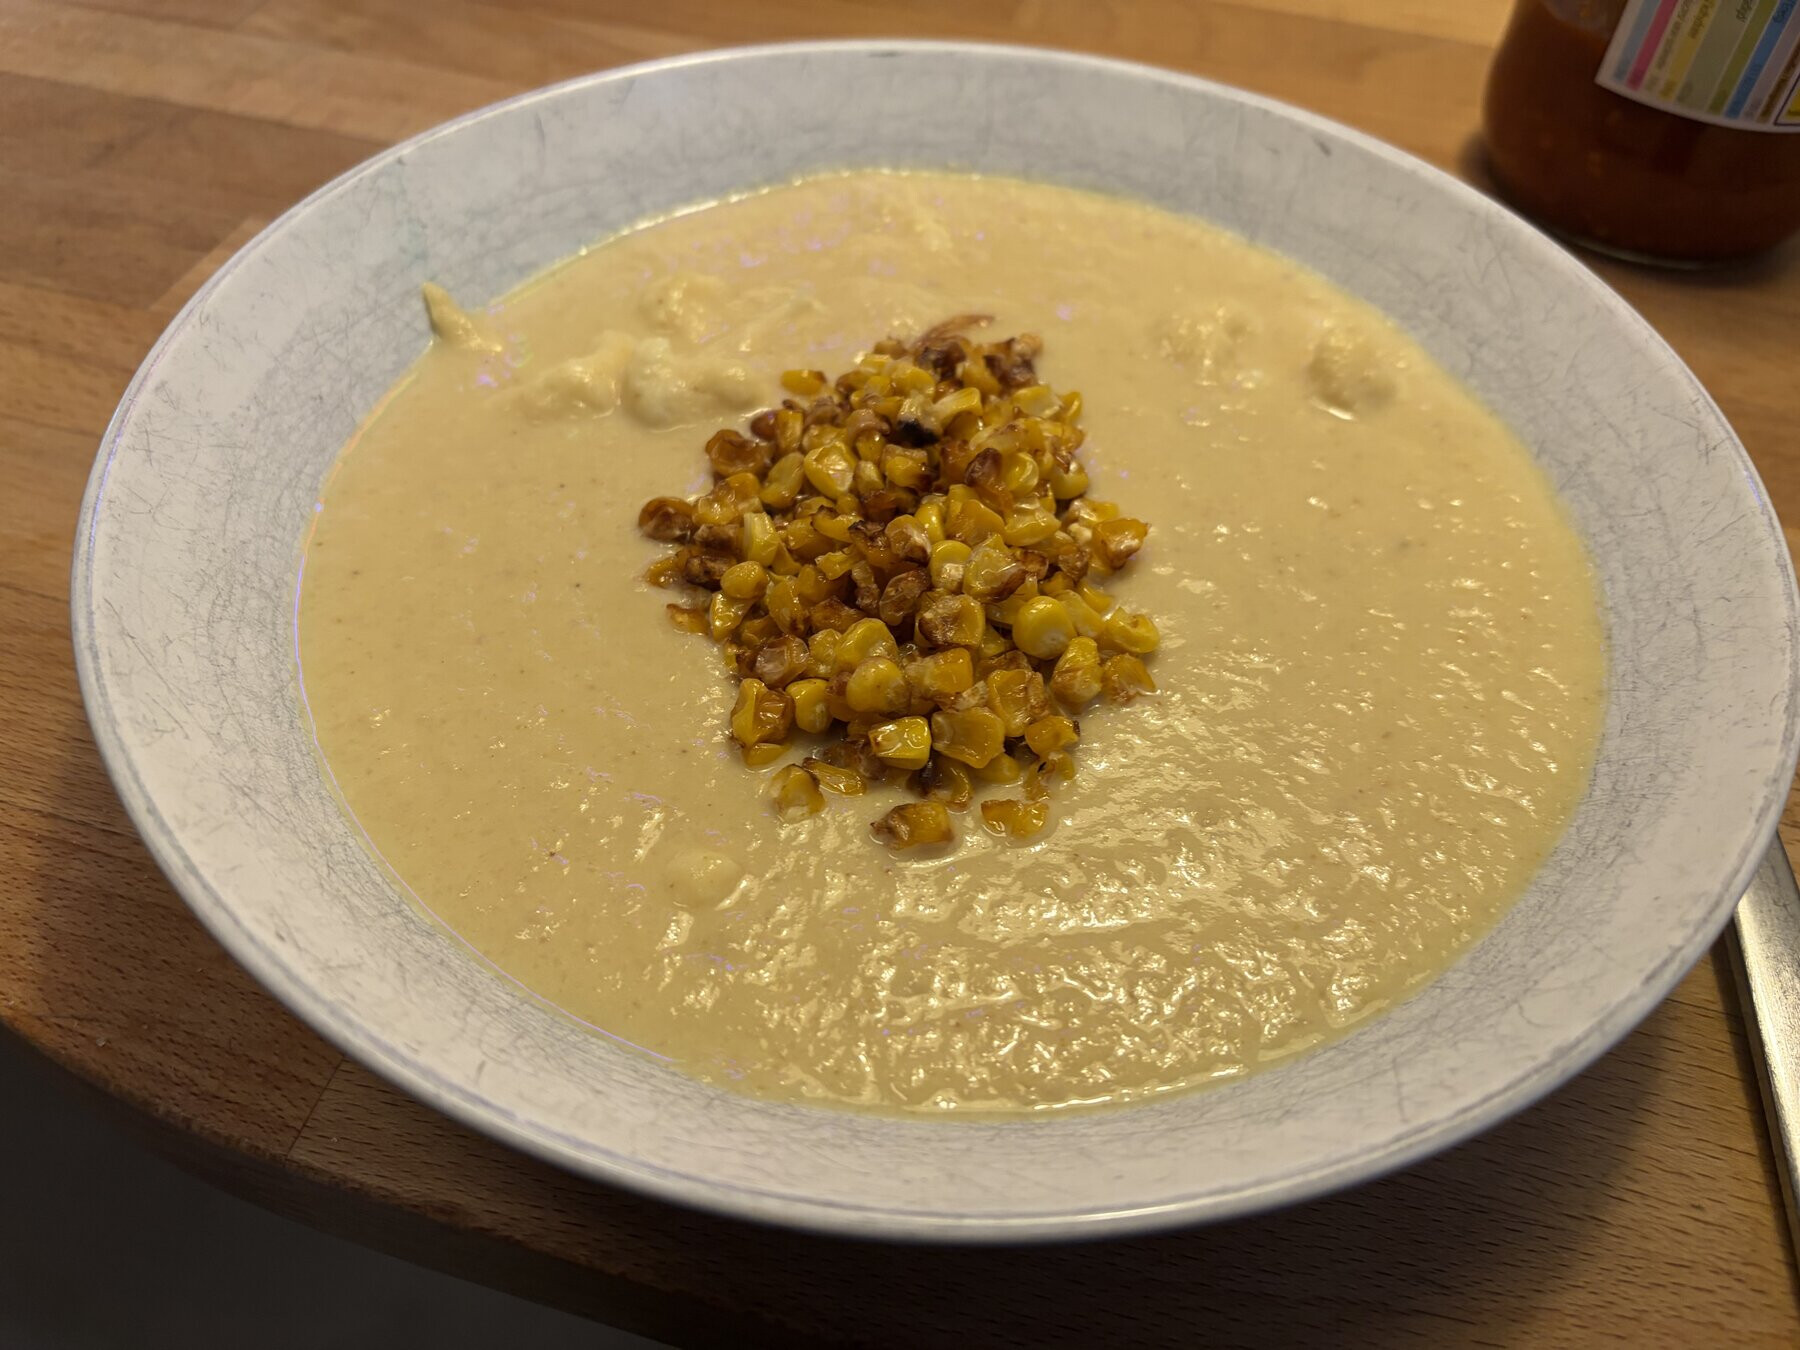
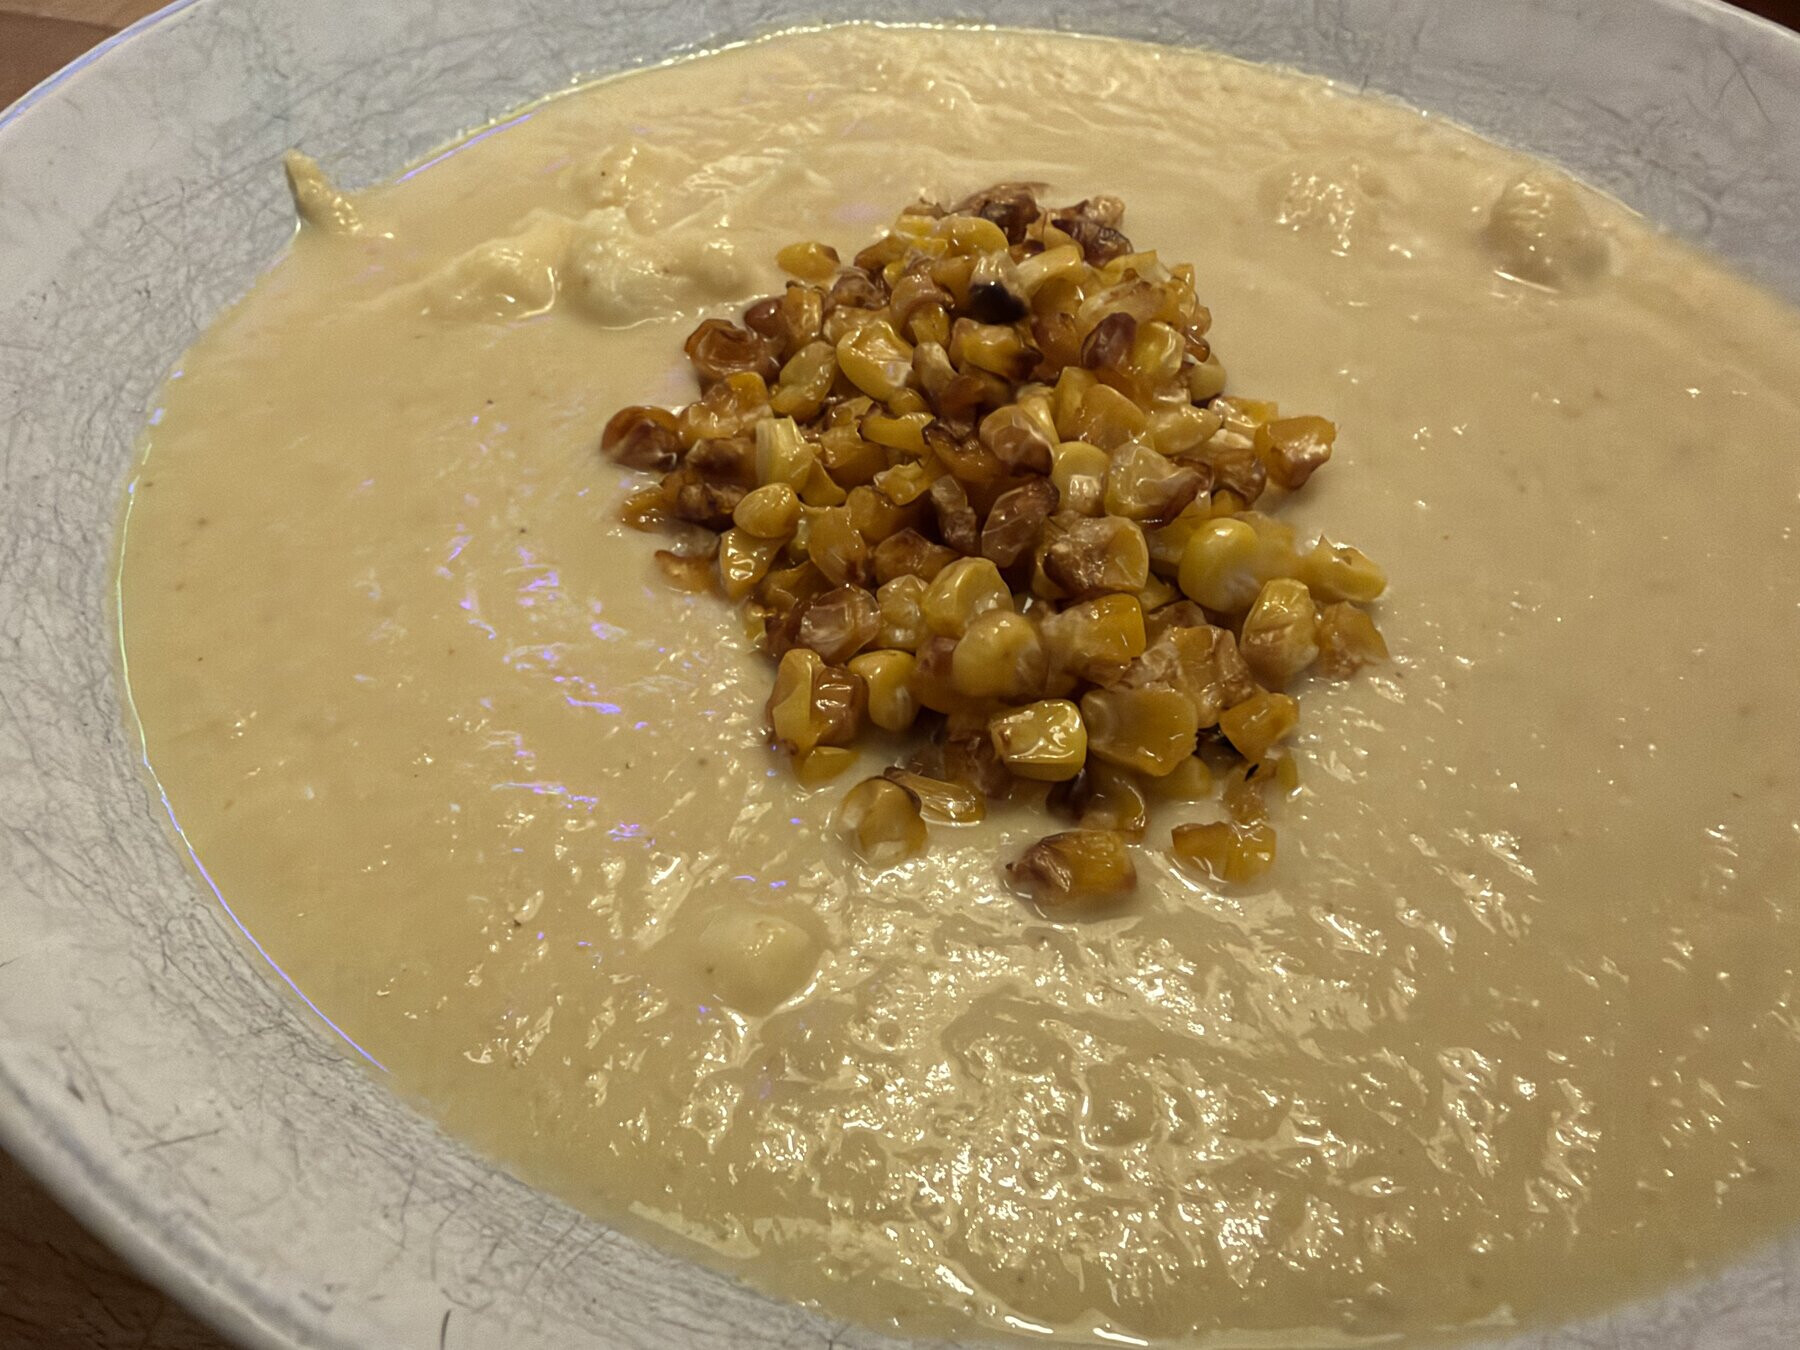
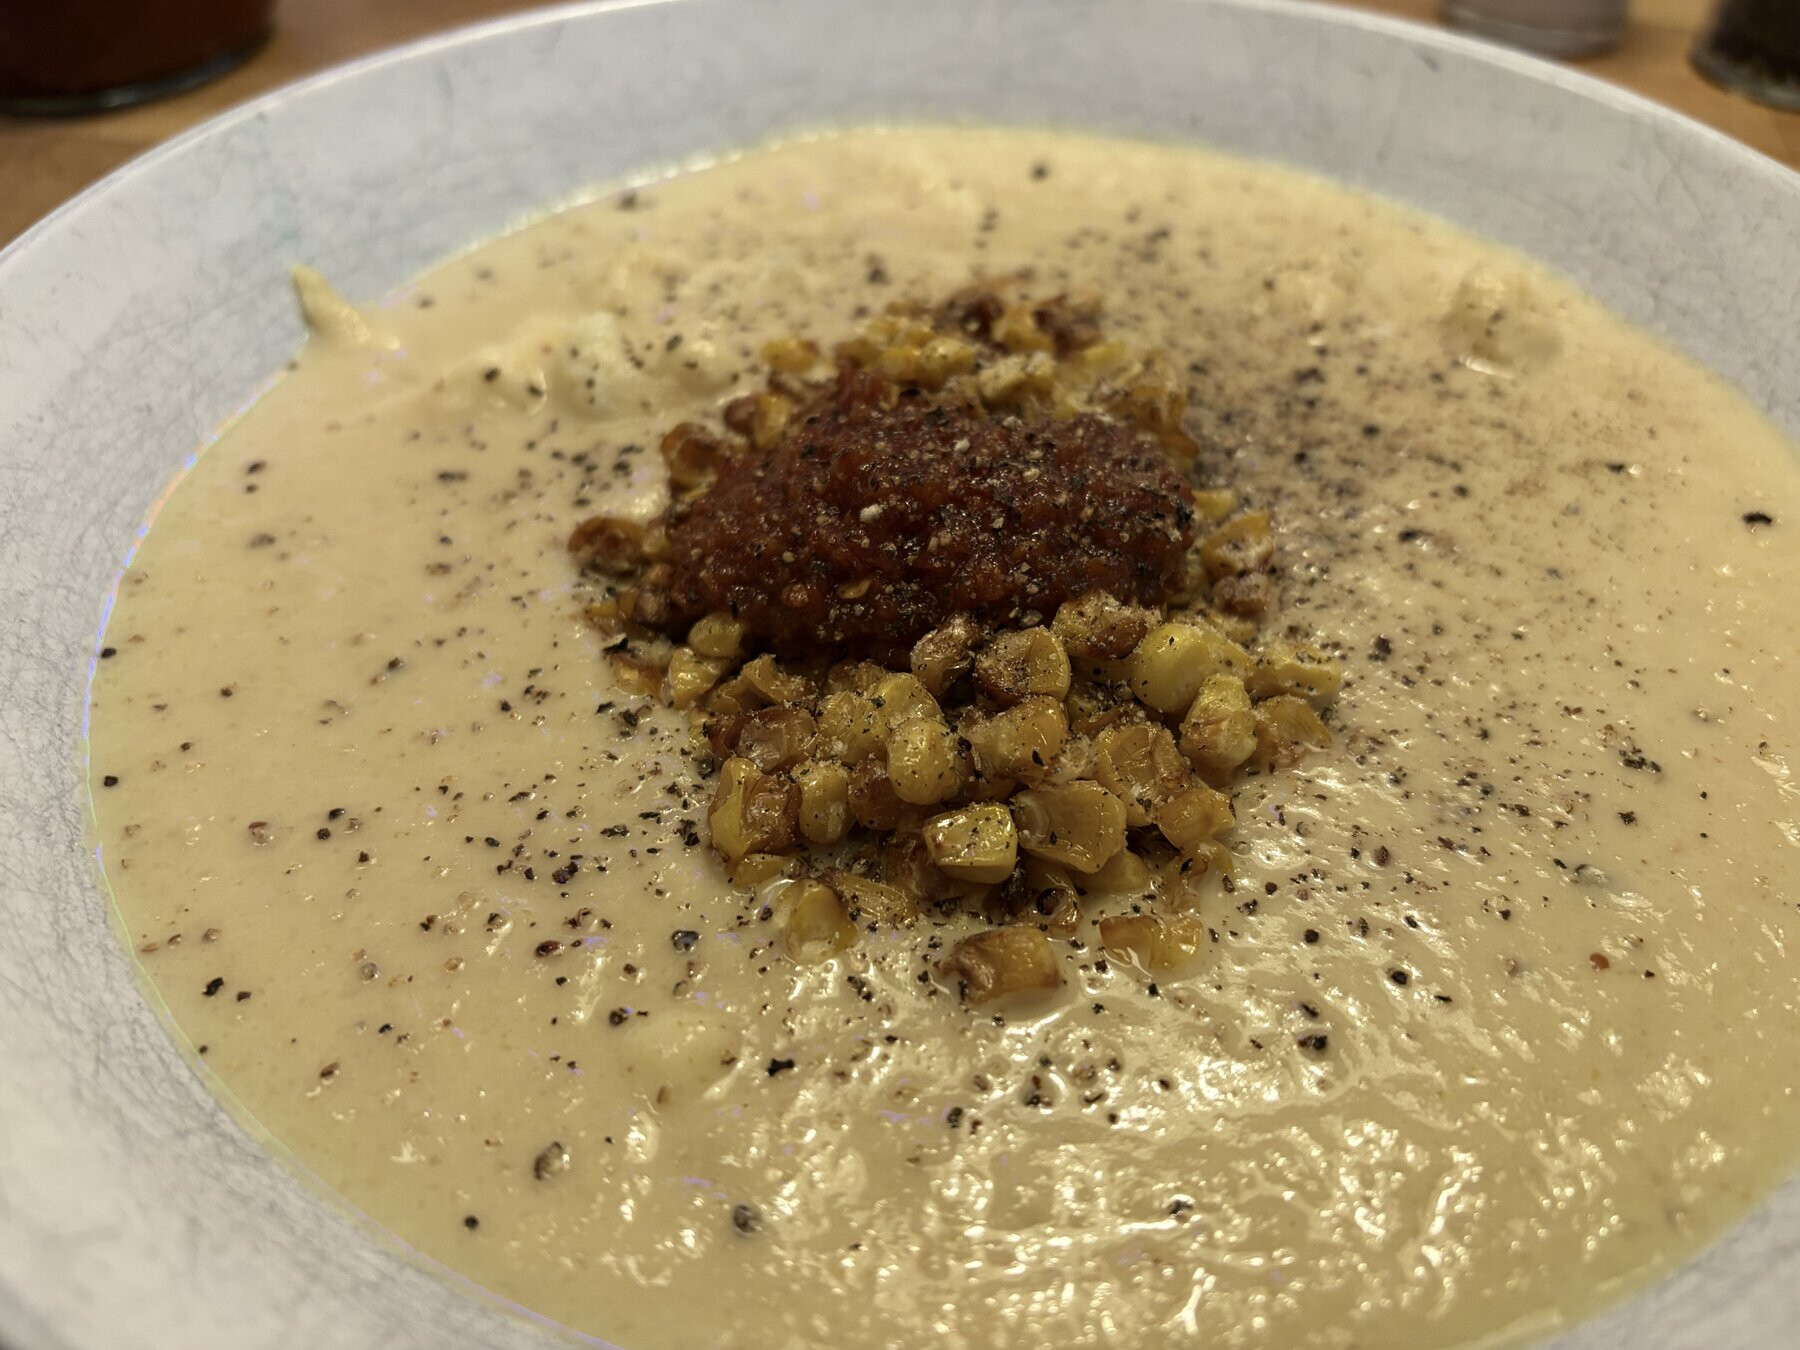
wenn ich eins in den letzten jahren in der küche gelernt habe, dann ist es rezepte als einstiegspunkt zu nehmen und dass man keine hemmungen beim neu-kombinieren haben sollte. pesto kann man zum beispiel aus fast allem machen: irgendwelche nüsse, gutes öl, parmesan und irgendwas mit farbe und geschmack. das können, ganz klassisch, kräuter sein, tomaten oder rote bete. geht alles, schmeckt alles. bei suppen ist es da gleiche, eine gute basis, eine einlage damit was was zu kauen hat und irgendwas crunchiges.
heute habe ich die gute alte blumenkohlsuppe nach anke gröners rezept wieder mal gemacht. die frittierten rote bete flöckchen im rezept sind so ungefähr das leckerste was es gibt, aber wir hatten keine rote bete. also hab ich die körner von zwei maiskolben im airfryer geröstet. das ergab auch eine tolle mahlzeit.
darüber hab ich schonmal geschrieben: robert alexanders Blogroll Network Map. ich bin da jetzt auch drin und man sieht ein paar relationen des teils der deutschen blogsshäre, deren teil ich bin. und wenn man seinen feedreader richtig voll machen will, könnte man die > 5000 feeds aus der bubbles-blogroll importieren. jedenfalls schön, dass das thema blogrolls gerade so viel aufmerksamkeit bekommt und viele menschen ihre blogrolls auf vordermann bringen oder sogar maschinenlesbar machen. ich hab in den letzten wochen einige neue feeds in meinen feedreader geworfen.
auf empfehlung von b30 hab ich mir auch lire installiert und teste das gerade. bisher war reeder classic der RSS reader meiner wahl auf dem taschenrechner, aber da gibts seit monaten oder gar jahren keine entwicklung mehr und der (new) reeder ist auch nicht so mein ding.
auf dem laptop nutze ich weiterhin das webfrontend von miniflux.
ich habe in den letzten tagen viele kleinigkeiten hier an der website repariert und gebaut, die mich entweder schon länger nervten oder die ich mir schon lange wünschte. besonders erfreut es mich, dass beiträge sich jetzt besser untereinander vernetzen. sammlungen verweisen auf beiträge und die dann wieder zurück zur sammlung, artikel die ich selbt verlinke setzen automatisch eine backlink („seiten die hierher linken“) und seiten die ich in artikel einbette verweisen jetzt auch zurück auf die seite in der sie eingebettet sind. dieser artikel hat zum beispiel schon sehr viele backlinks gesammelt.
aber am meisten freue ich mich über ein kleines feature, über das ich mich wundere, dass es mir noch nicht viel früher eingefallen ist. am fuss jedes beitrags steht das veröffentlichungsdatum. und statt das datum einfach nur dahin zu schreiben, verlinken der tag, monat und das jahr auf die jeweiligen archivseiten. heute am 13.09.2026 sähe das so aus. das ist wirklich praktisch wenn ich zufällig auf einem alten artikel von mir lande und sehen will was ich sonst so an diesem tag getrieben habe. zum beispiel waren wir heute vor 10 jahren an diesem tag in tschechien.
greenwashing kennt ja mittlerweile jeder. pinkwashing kannte ich noch nicht, hab ich aber schon öfter beobachtet (LGBTQ+-freundlichkeit zu imagezwecken herausstellen). aber wie würde man das hier auf dem foto nennen? asswashing ergibt ja irgendwie keinen sinn?
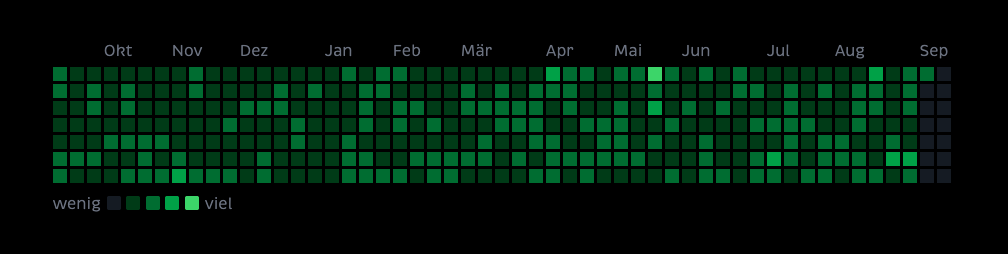
vor 531 tagen schrieb ich „hallo kirby“, nachdem ich wirres.net mit kirby wieder belebt hatte. und seit 500 tagen habe ich jeden tag etwas veröffentlicht. nicht unbedingt jeden tag einen text, aber mindestens ein bild oder einen checkin.

ich bin ganz zufrieden mit dem, was ich mir hier in den letzten letzten anderthalb jahren zusammengedengelt habe. auf der vorderseite sieht’s aus wie das was ich mir als blog vorstelle, 1-2 tägliche beiträge in denen ich das abbilde was ich gesehen habe, was mich beschäftigt, was ich empfehle, was ich gegessen habe. dahinter ein weiterer fluss mit bookmarks, likes oder reposts von sachen die mir begegnet sind, aber oft noch unsortiert, unkommentiert oder zu lieblos für die voderseite sind. die 84 bilder vom baum den ich mir im letzten winter vorgenommen habe jeden tag wenn ich dran vorbeikomme zu fotografieren muss nicht jeder sehen. aber für mich ist es die wiederentdeckung des logs in weblog. in die gleiche kerbe (loggen) fällt mein medienmenü oder medienlog, in dem ich filme, serien und bücher logge, die ich gesehen oder gelesen habe. tatsächlich tauchen dort seit januar nur filme und serien und youtube-stunden auf, die ich mit dem laptop gesehen habe. keine bücher. obwohl ich im märz ein buch angefangen habe. und im september gleich zwei. zuende gelesen hab ich seit jahren keins mehr (aber ich bin dran).
aber das ist ja der witz an der sache mit dem loggen: mir selbst visualisieren womit ich meine zeit verbracht habe und womit nicht und wo diese zeit hin ist. eigentlich war das von anfang an eine motivation für mich ins internet zu schreiben: wenn die zeit schon mit steigendem tempo an mir vorbeirauscht, dann wenigsten die eine oder andere erinnerung festhalten.
wenn ich mir den aktivitätsgraphen der letzten 12 monate ansehe, erkenne ich auch, dass ich seit dem frühjahr auch mehr uns mehr auf den geschmack komme. die felder werden heller, ich veröffentliche also auch mehr und mehr.
nutze ich KI? klar, vor allem im maschinenraum. während ich früher diese webseite mit hilfe von gegoogelten codeschnipseln zusammendengelt habe, überlasse ich den grossteil des codings mittlerweile diversen KI-modellen. das prinzip ist das gleiche wie früher: ich stelle mich mit meinen ideen auf die schultern von anderen, die das mit dem coden besser können, um meine ideen umzusetzen. ich lese zwar weiterhin, wie früher, liebend gern den quellcode von webseiten und versuche zu verstehen wie dinge funktionieren, ich staune, wenn ich CSS-, microformat- oder json-ld-spezifikationen lese, ich freue mich über denkarbeit, die andere in plugins stecken und die ich dann adaptieren kann, aber eigentlich ist das prinzip, wie ich meine webseite baue, seit 30 jahren unverändert: ich kopiere und stehle code um daraus was eigenes zu machen. mit KI geht das ganze nur einen ticken schneller.
ob ich damit im jobs’schen/picasso’schen sinne ein good oder great artist oder gar kein artist bin, weiss ich auch nicht.
Good artists copy, great artists steal.
was zählt: ich hab mir mein haus selbst gebaut, auch wenn mir dabei sehr, sehr viele andere geholfen haben, deren code entweder open-sourced ist, googlebar war oder von LLMs zum lernen genutzt wurde. umgekehrt helfe ich (hoffentlich) anderen, auch was eigenes zu bauen, indem ich meine ideen hier frei verfügbar hinausposaune.
und für recherche nutze ich KI natürlich auch. oder wie nennt man das, wenn man etwas weiss, mal gehört hat, sich aber nicht mehr genau erinnern kann? genau dafür nutze ich auch immer wieder LLMs.
wie hat das steve jobs sagt, „xx kopieren, künslter klaubne bei den bestenb?“
Du meinst sehr wahrscheinlich das Zitat, das oft Steve Jobs zugeschrieben wird:
“Good artists copy, great artists steal.”
Jobs verwendete diese Formulierung 1996 in einem Interview und bezog sie auf die Idee, sich von hervorragenden Arbeiten anderer inspirieren zu lassen und daraus etwas Eigenes zu schaffen. Der Satz stammt allerdings nicht ursprünglich von Jobs; er wird häufig Pablo Picasso zugeschrieben, wobei auch diese Zuschreibung nicht eindeutig belegt ist.
andererseits ist die nutzung von KI für solche fragen manchmal auch quatsch. kagi und google hätten mir mit dem gleichen wortlaut der frage auch helfen können. kagi präsentiert das ergebnis allerdings in suchergebnissen, google als KI zusammenfassung.
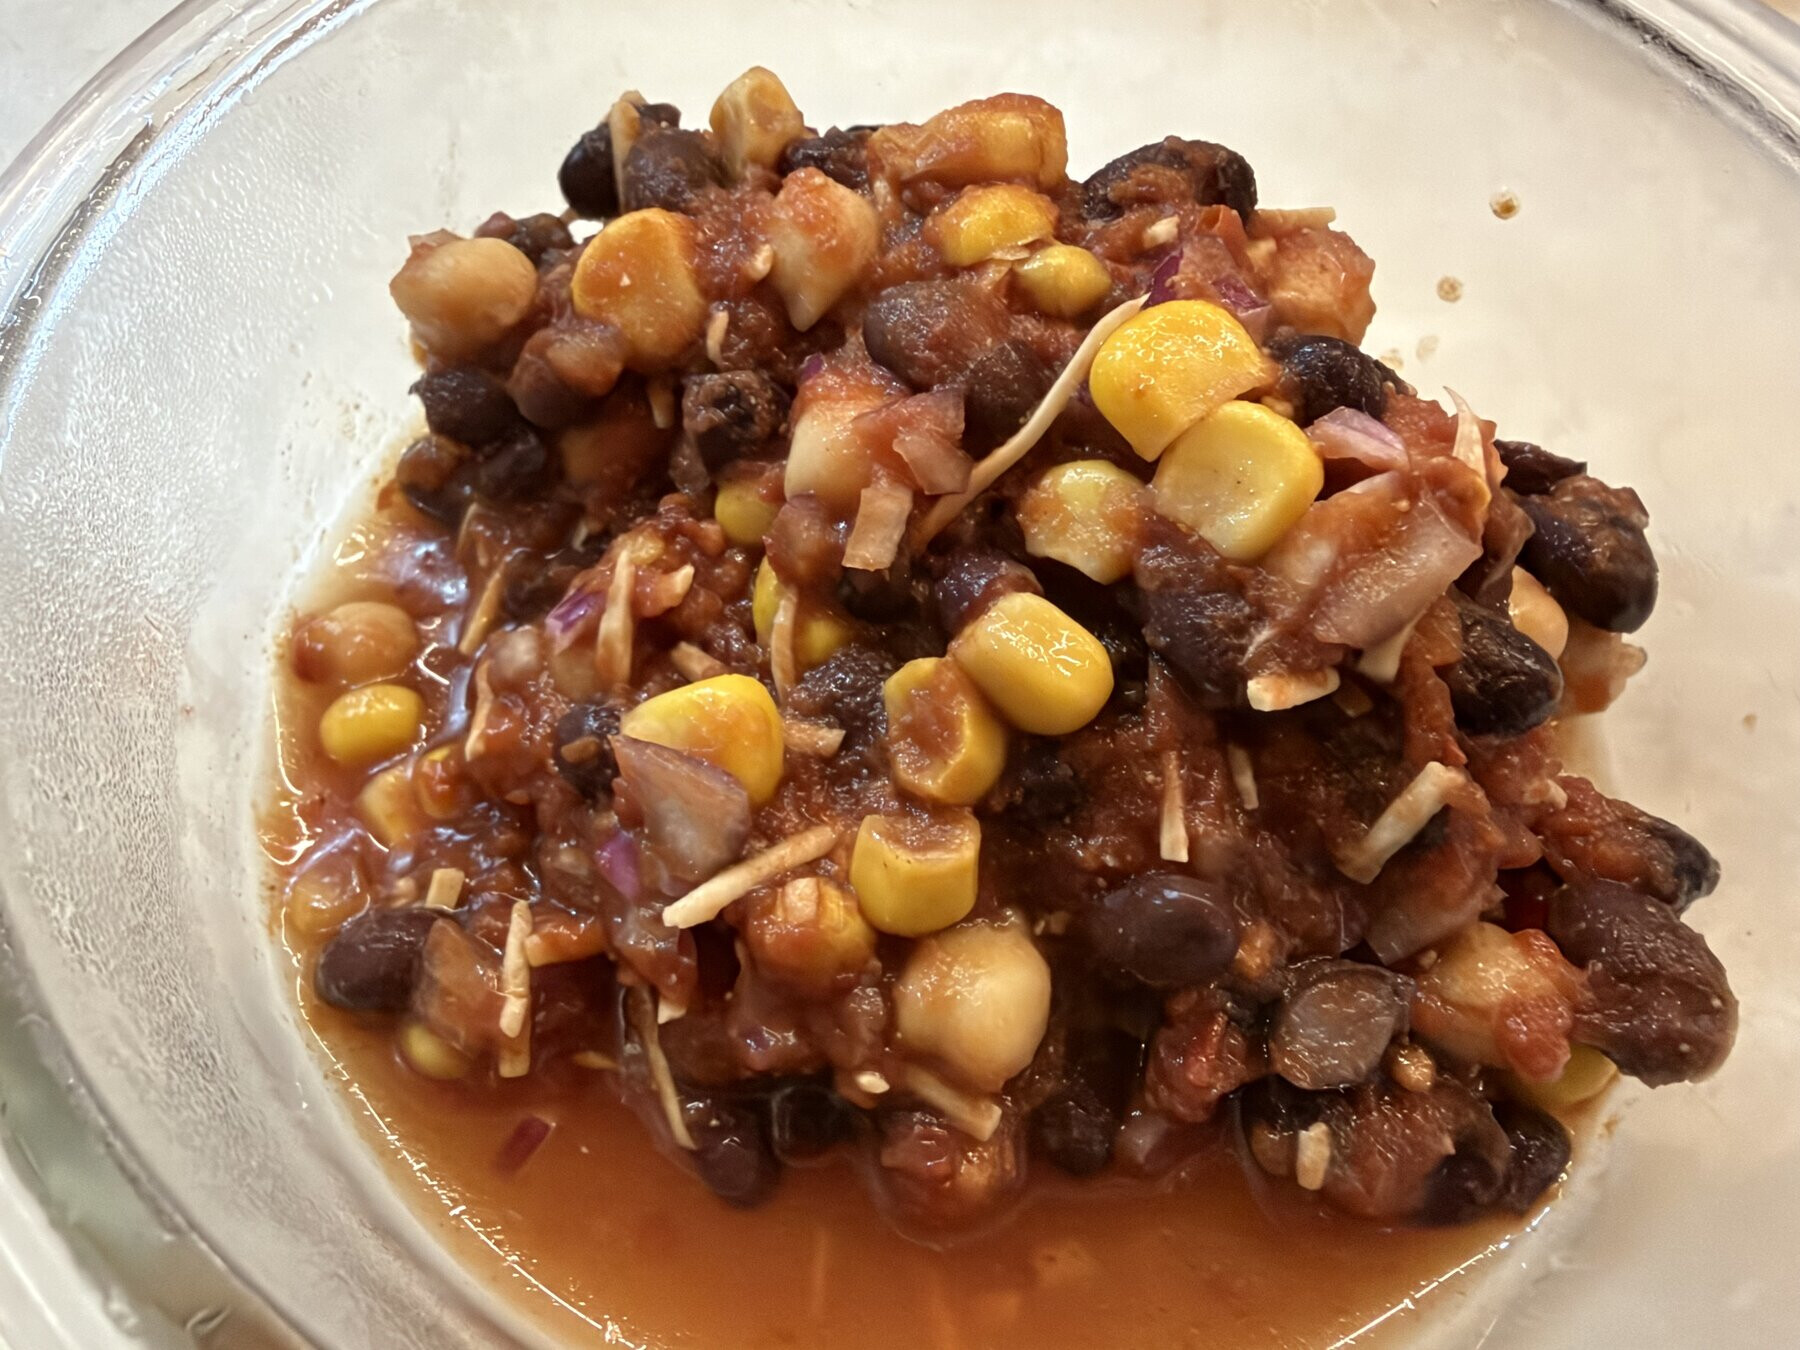
ich koche übrigens genauso, wie ich blogge. einerseits suche ich nie perfektion, sondern immer effizienz, andererseits nehm ich den ganzen aufwand in kauf, damits mir schmeckt und freue mich, wenns auch anderen oder der beifahrerin schmeckt. auch was ich koche oder blogge hat oft den gleichen ursprung: die beifahrerin sagt gelegentlich: „mach doch mal chili con carne“ oder sucht mir rezepte raus und ich guck dann was ich draus mache. ist beim bloggen nicht anders: irgendjemand macht xy im internet und ich gucke was ich daraus mache.
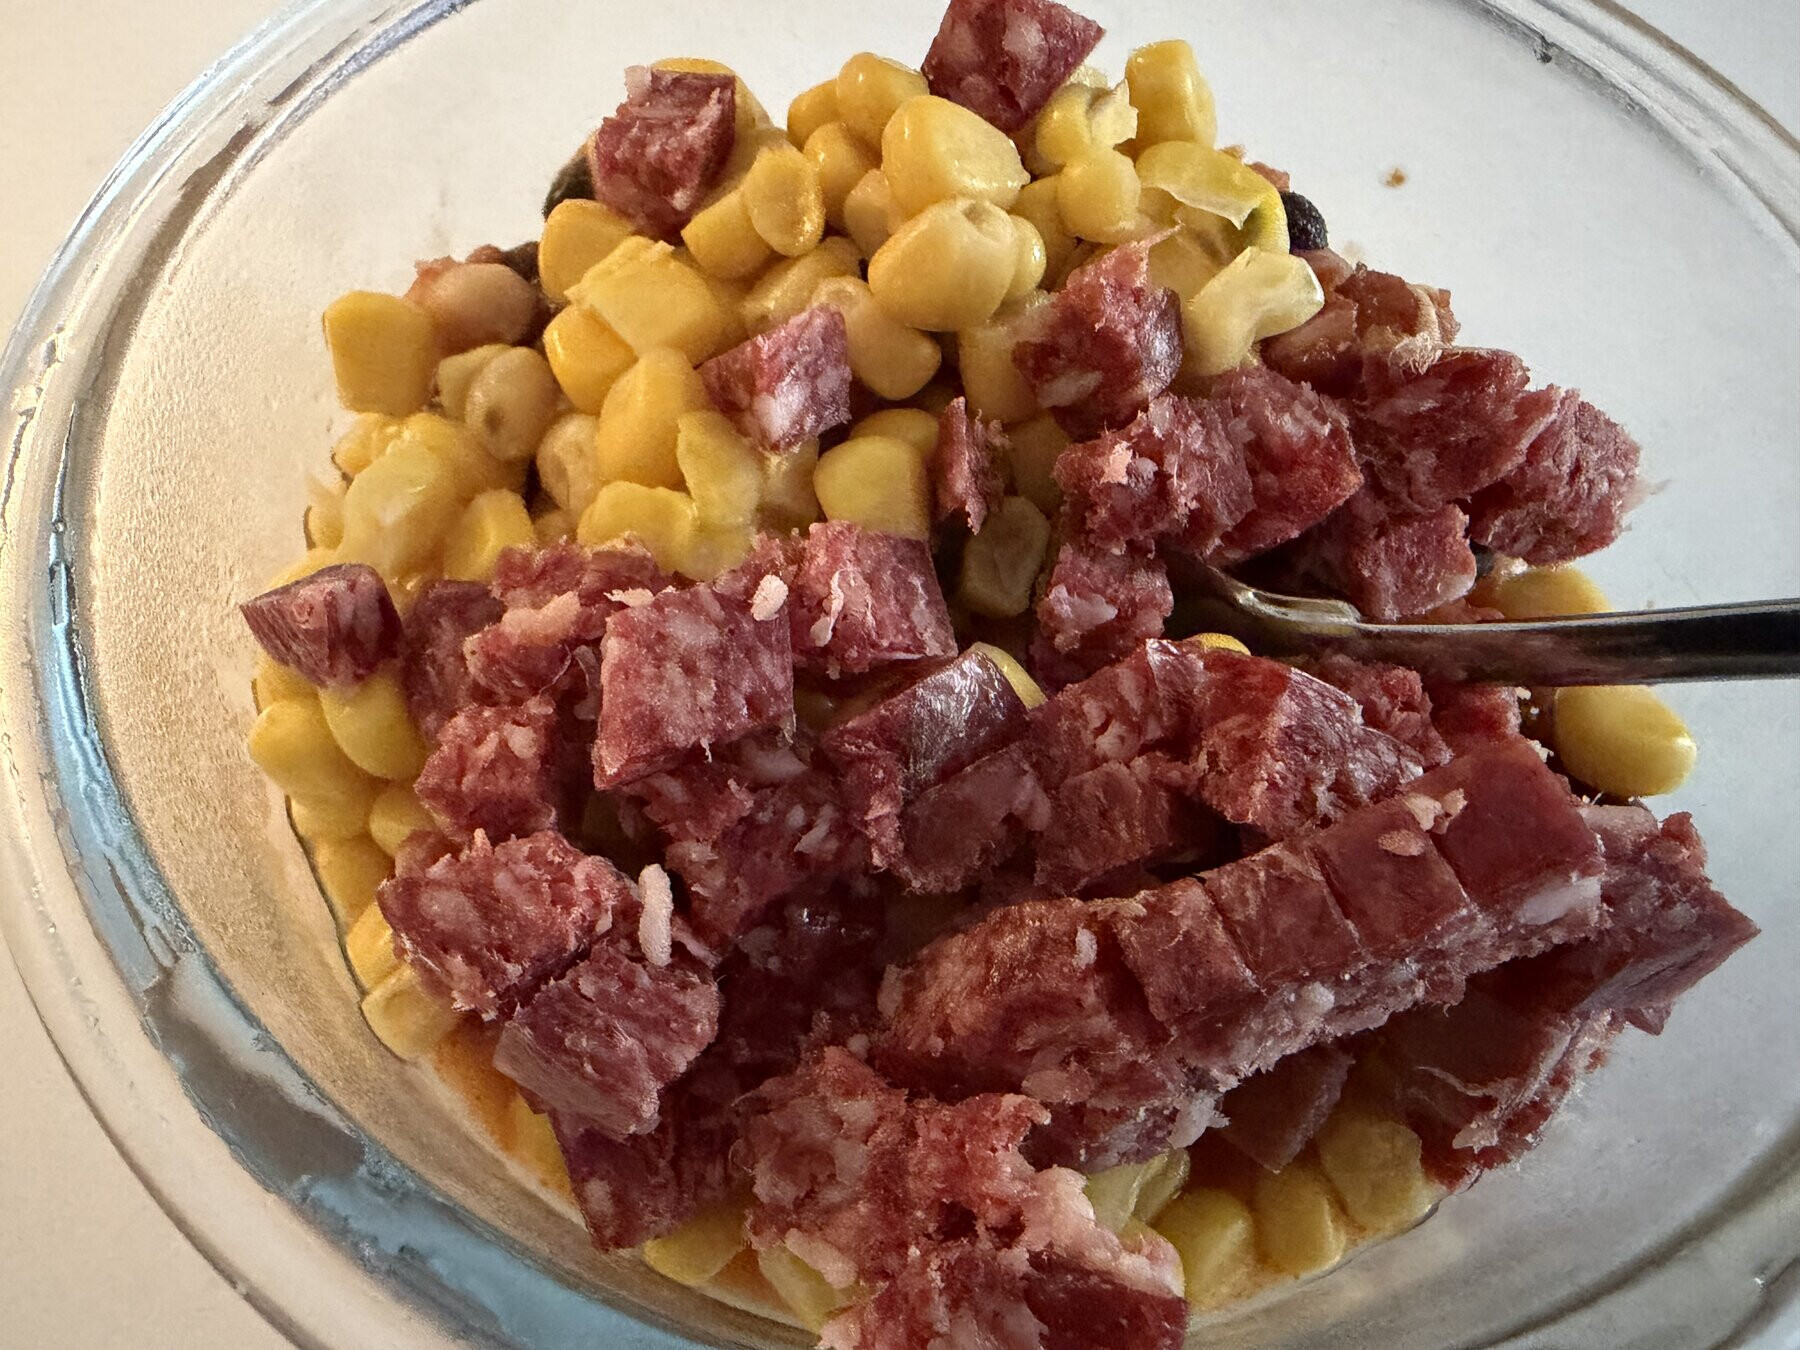
gestern dachte ich mir: warum chili con carne a la jamie oliver eigentlich überhaupt kochen? also gabs gestern zum abendessen extra fein gewürfelte rote zwiebel mit einer dose mutti-tomaten, einer kleinen dose kichererbsen, einer dose schwarzen bohnen, etwas dosenmais (abweichend vom originalrezept), etwas balsamico, etwas sojasauce, etwas kreuzkümmel, etwas zimt und wie erwartet ergab das ein sehr leckeres, gazpachio-artiges gericht. frische, feingewürfelte paprika hätte dem ganzen auch gut getan, hatten wir aber nicht mehr. heute früh hab ich den rest von gestern abend mit salami-würfeln verlängert. chili con salami war auch gut.
ich habe schon lange nicht mehr dokumentiert was ich hier im maschinenraum getrieben habe.
was ich schon lange mit mir rumgetragen habe und jetzt, nach einer inspiration von rast und rost, endlich so umgesetzt habe, dass es mich erfreut: sammlungen.
eigentlich hab ich das jetzt schon ein paar wochen, aber die reziprokität hab ich erst in den letzten tagen umgesetzt. ein artikel, der sich in einer sammlung befindet, zeigt das unter der überschrift mit einem hinweis und link auf die sammlungsseite an. das ist zwar schon reziprok, aber auch sehr subtil. weniger subtil ist (jetzt neu) eine liste der ganzen sammlung unter allen artikeln einer sammlung. so sieht das zum beispiel unter dem chili con carne rezept aus:
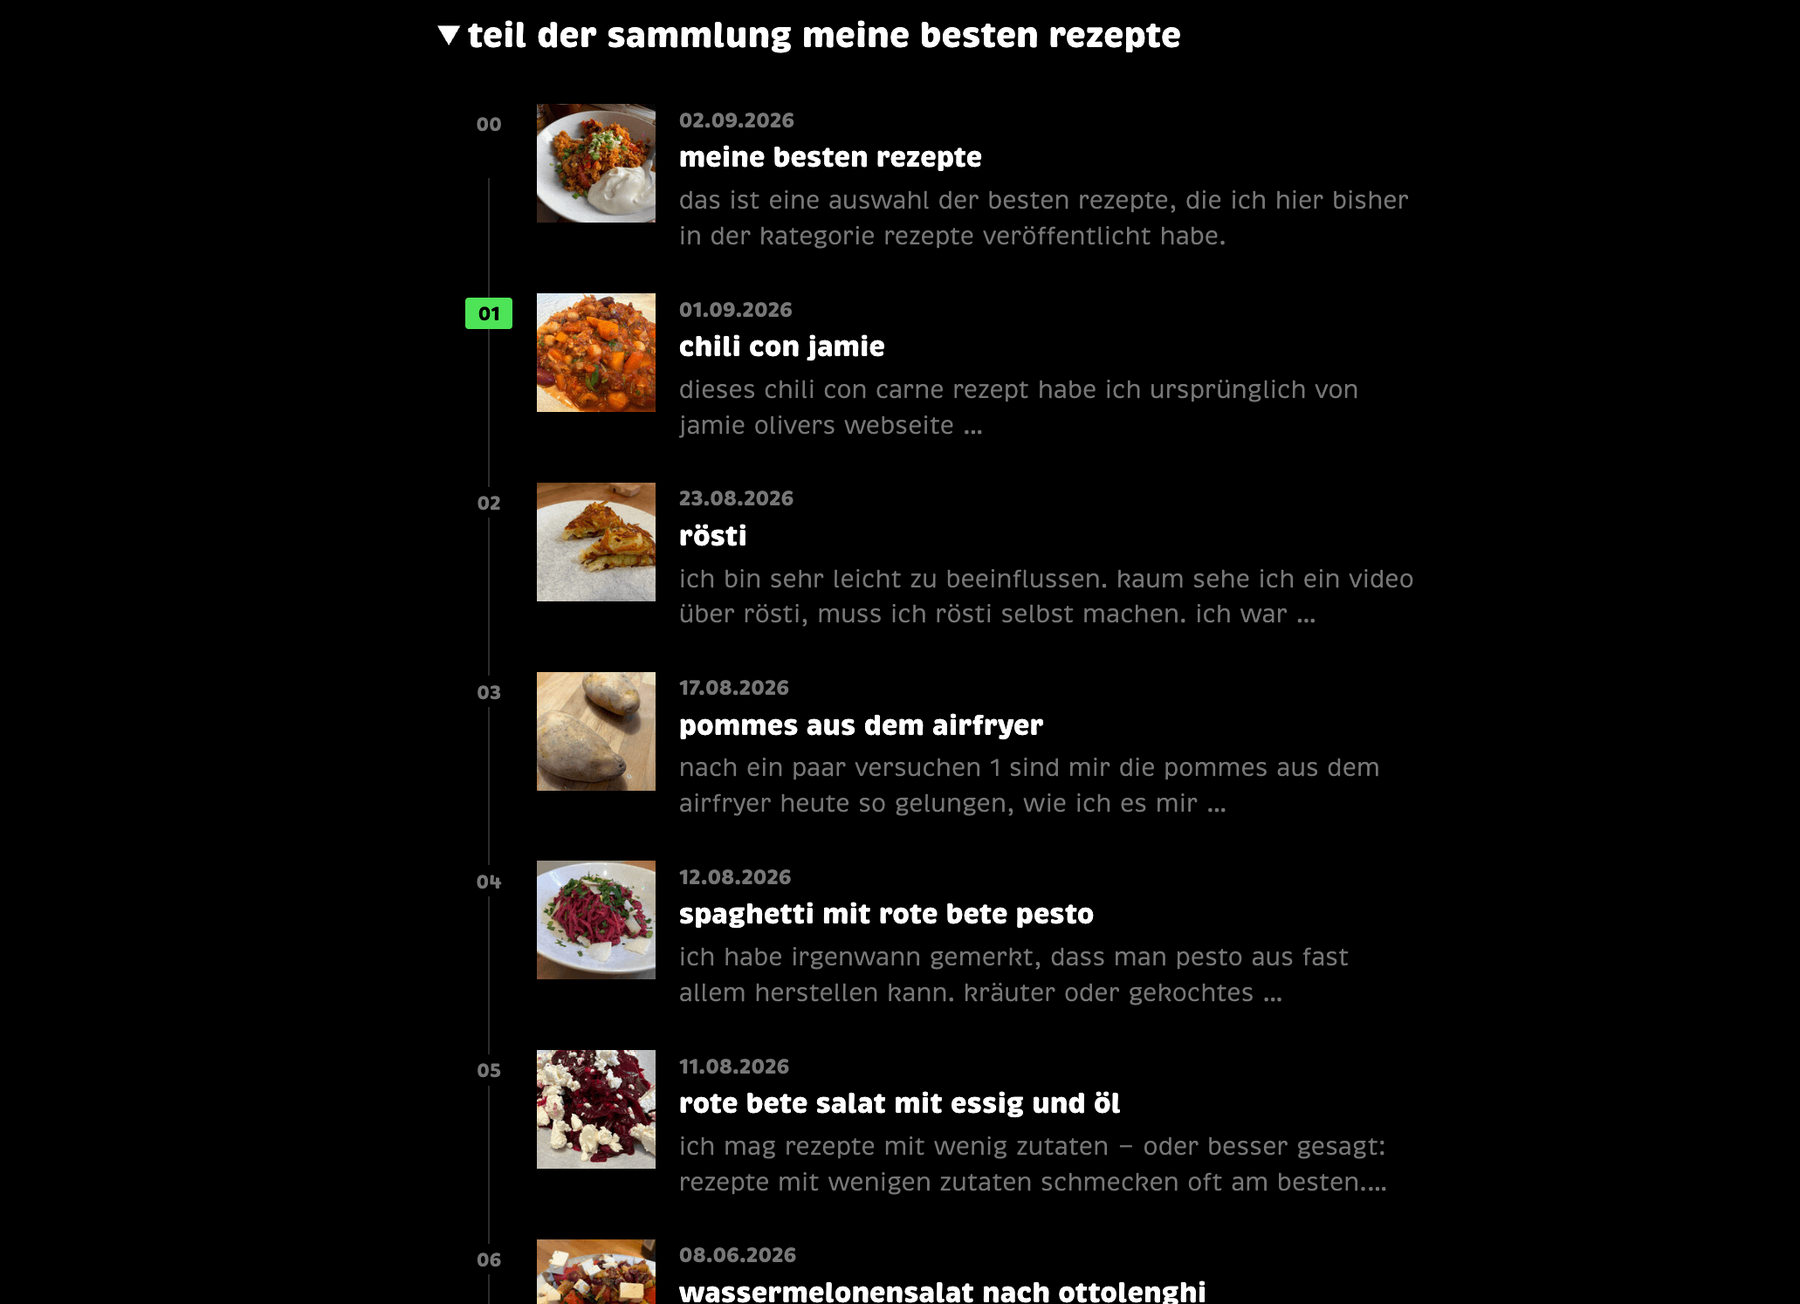
das ist die rezeptsammlung und das die übersicht meiner bisherigen sammlungen.
bei kottke.org hab ich den fixen „via“-link geklaut. ein via kann ich natürlich auch wie in den letzten 30 jahren im fliesstext setzen, aber so formalisiert, mit einem feld im backend finde ich das auch sehr gut, gerade zum beispiel für kurze empfehlungen, zu denen ich gar nicht viel schreibe (beispiel).
ich kann jetzt aus dem backend fotos zu instagram und grain schicken. grain ist einer der wenigen ATmosphere dienste die nicht schnarchlangsam sind und mir immer noch sehr gut gefallen. grain ist wie instagram früher war.
neben fett, kursiv oder durchgestrichen, kann ich jetzt auch text highlighten.
und natürlich der aus meiner primären blogrolle generierten reader. ich beobachte mich dabei, wie ich den reader ziemlich oft nutze, obwohl die feeds auch alle in meinem regulären feedreader sind. aber es ist schön mal schnell nachzusehen, ob in den blogs, die ich gerne lese, was neues steht. und so zwinge ich mich auch, öfter mal die webseiten zu besuchen, als nur immer alles in meinem feedreader zu lesen.
was ich auch toll finde, dass die blogrollen jetzt nach letzter aktivität sortiert sind. alphabetisch oder nach präferenz sortieren ist so ungerecht. aber die sortierung ihrer nachbarschaft nach bezeichnungslänge von frau klugscheisser gefällt mir auch sehr.
johannes kuhn nennt das „notizblog“, caro (und einige andere) 12 von 12, ich nenne es tagebuchbloggen oder heuite mal zeiterfassung.
→ lesen …
claudia hat aufgeschrieben, was sie beim kommentieren (in blogs) nervt. von meinen vorherigen kommentarsystem war sie (zu recht) genervt. mit der einbindung von isso ist sie zufrieden, aber ich selbst auch.
obwohl ich isso jetzt seit fast zwei monaten in betrieb habe, ist hier noch kein spam-kommentar gelandet. das mag daran liegen, dass es (derzeit noch) ausschliesslich über javascript funktioniert. das nervt claudia nicht, aber andere — und ich möchte das langfristig noch ändern. ansonsten habe ich isso wirklich niedrigschwellig konfiguriert: wer mindestens drei zeichen kommentar eingibt, kann das formular und damit einen kommentar abschicken. die angabe des namens, der emailadresse oder der eigenen website ist optional. so oder so gibts eine vorschau und die option den kommentar 30 minuten lang (nach der veröffentlichung) zu editieren (über einen cookie). markdown ist unterstützt, links werden klickbar, lediglich der hinweis darauf, dass markdown unterstützt wird, fehlt noch. wobei ich glaube, dass, ausser ein paar spezialisten, ohnehin niemand weiss was markdown ist.
jedenfalls denke ich, claudia hat recht. ich finde es auch extrem nervig, wenn man einen kommentar schreibt und nach dem senden entweder nix passiert oder ein hinweis auf moderation erscheint. wenn schon moderation, dass könnte der kommentar mir selbst doch wenistens weiter angezeigt werden?
ich kommentiere schon länger so, dass ich kommentare, die ich anderswo hinterlasse, auch hier veröffentliche. wie alles was ich hier mache, mache ich das natürlich in erster linie für mich selbst. so kann ich später schauen ob es antworten gab, ob die moderation erfolgreich war oder gelöschtes zumindest bei mir selbst behalten. und für die eine oder andere person mag es sogar interessant sein zu sehen, was ich anderswo ins internet schreibe.
aber am liebsten ist mir das kommentieren per webmention. das geht nicht überall, aber zum beispiel bei eay.de oder dem kopfzeiler. ich schreibe aber beim webmention-kommentieren nicht nur eine antwort unter einen fremden beitrag, sondern ich behalte auch die fähigkeit den zu editieren oder zu löschen. das finde ich ziemlich sensationell. mit wordpress kann man das kommentieren per webmention mit (natürlich) matthias pfefferles indieweb-plugin konfigurieren, mit kirby und ein bisschen handarbeit hilft einem maurice renks indieconnector.
was mich im gegenteil zu claudia nicht nervt: wenn man gar nicht kommentieren kann.
Kommentieren unmöglich: Blogg doch selbst, steht dann z.B. da. Ok, alles klar, ich lese dann aber auch nicht mehr mit. Für mich sind Blogs die einzig verbliebenen Medien, wo noch gute Gespräche möglich sind – keine Wandzeitungen.
die gespräche sind ja immer noch möglich. diesen sermon hier möchte ich nicht unter claudias eintrag posten, aber trotzdem ist dieser beitrag auch ein kommentar. claudia wird diesen artikel sehen, entweder in ihren referern oder bei rivva. oder weil sie hier zufällig mal reingeschaut hat. das ist ja das tolle am internet, an links, an eienr wandzeitung. besteht alles irgendwie aus gesprächen und kommentaren.
nachdem ich vor ein paar tagen im 2005er archiv dieser webseite gewühlt habe und drüber geschrieben habe, konnte ich in den letzten tagen einen 20 jahren alten punkt von meiner tofoliste streichen: die beiträge die ich damals ins wahlblog.de geschrieben habe auf wirres.net kopieren.
weil das schnell unübersichtlich wurde habe ich eine sammlungsseite verfasst, die das alles bündelt: sammlung #wahl05
sammlungen sind eine idee die mir frank westphal mindestens einmal ins ohr gelegt hat. die sammlungsseite habe ich als einfachen blogbeitrag angelegt, aber alle in ihr erwähnten oder relevanten beiträge linken auf den artikelseiten wieder zurück auf die sammlung (beispiel). so eine art kontext-klammer finde ich gut.
weil ich gerade dabei war zu schauen was ich sonst noch so über parteitage schrieb, fiel mir auf wie nötig solche übersichtseiten sind. ich erinnerte mich, dass ich in den folgejahren noch ein paar mal auf parteitagen war und darüber schrieb. aber so richtig zurechtgefunden habe ich mich in meinem archiv nicht. also habe ich das mal etwas sortiert und für die anderen parteitage eine eigene sammlung angelegt: sammlung parteitage
in der #wahl05 sammlung schrieb ich, dass ich zwar das archiv aufgeräumt und etwas strukturiert habe, die wahlblogseiten aber weiterhin für suchmaschinen indexierung sperre:
das archiv dient meinem privatvergnügen und ich empfehle niemandem den alten scheiss von mir zu lesen (obwohl es teilweise ganz amüsant zu lesen ist).
so wie ich vor 20 jahren schrieb, würde ich heute nicht mehr schreiben, aber in 20 jahren werde ich das sicher nochmal interessiert lesen. so wie ich es jetzt, 20 jahre später auch nochmal (fast) alles gelesen habe. aber sonst muss das wirklich keine(r) lesen, auch wenns geht.
ich habe cursor mal meine apache logs auswerten lassen, wer in den letzten 14 tagen hier seiten aufgerufen hat. wie man sieht, machen offenbar suchmaschinen-indexer und echte besucher nur einen sehr kleinen teil aus. den grössten batzen machen hier täglich so um die 40-50 tausend bots oder scripte aus. im prinzip habe ich hier ein riesiges cache-warming botnetz.
RSS feeds häufig und von überall aus abzurufen ist durchaus im sinne des erfinders, aber wenn man das auf minuten runterrechnet, sind das im schnitt acht abrufe meiner RSS feeds pro minute.
| bots & scripts | LLM | indexer | humans | Σ | |
|---|---|---|---|---|---|
| seiten | 43.000 | 4.800 | 4.200 | 400 | 52.400 |
| RSS | 10.900 | - | - | 1.000 | 11.900 |
.md |
180 | - | 30 | - | 210 |
| summe | 54.080 | 4.800 | 4.230 | 1.400 | 64.510 |
eigentlich wollte ich sehen, wie die markdown-dateien angenommen werden. es zeigt sich: nicht schlecht, im schnitt 200 aufrufe pro tag, aber nichts gegen den abruf von 50 tausend html-seiten durch bots, scraper und indexer. die „humans“ zahlen sind auch eine optimistische näherung. das matomo-pixel das ich in den RSS feed gepackt habe tählt um die 400 RSS leser täglich, aber da mein matomo-host stats.wirre.net auf einschlägigen ad- und trackerblocker listen steht, dürfte 1000 leser ungefähr und mit etwas optimismus passen. die 400 menschlichen seiten-leser sind der tägliche schnitt laut matomo ohne optimismus zuschlag.
tl;dr: i’m blogging for the bots
interessant finde ich, dass rezepte mittlerweile dank google die meistbesuchten seiten hier sind (ausser der startseite). die zahlen sind auch aus den letzten tagen auf die unique pageviews pro tag runtergerechnet.
tl;dr: google schickt suchende nur noch auf rezepte.
ich hab in den letzten monaten immer wieder überlegt wie ich artikel von hier auf instagram bringen kann oder umgekehrt. auf instagram habe ich immer noch viele menschen die mir folgen, oder besser gesagt, die auf pflanzenbilder und selfies von mir reagieren. instagram selbst nutze ich selbst so gut wie gar nicht mehr, weil ich mich immer ärgere wenn ich die app offen habe und verführt werde kurze videos in mich reinzustopfen. zack sind 30, 40 minuten vorbei und ich ärgere mich, dass ich meine zeit nicht selbstbestimmt verschwendet habe.
die schwierigkeiten die instagram einem in den weg legt wenn es darum geht eigene inhalte von instagram zurückzuholen sind erstaunlich. instagramm gibt sich sehr viel mühe öffentliche beiträge nicht automatiert auslesabr zu machen, ausser man heisst googlebot. jedenfalls hab ich mehr oder weniger aufgehört auf instagram zu posten, weil das kopieren der beiträge von instagram hierher zu mühsam wurde und umgekehrt nicht möglich ist.
ausser man wandelt sein instagramkonto in ein professionelle konto um, meldet sich bei facebook als entwickler an, verknüpft sein facebook und instagramkonto und stellt an einigen stellschraben rum. nach langem zögern hab ich das jetzt gemacht und kann beiträge von hier einfach auf instagram posten — per knopfdruck im kirby backend.
im indieweb nennt man das posse: „Publish (on your) Own Site, Syndicate Elsewhere“
ich veröffentliche also hier ein foto und von hier dann zu mastodon, bluesky, standard.site — und jetzt auch zu instagram. und jetzt wo ich über meta/facebook auch eingeschränkten zugang zur API habe, kann ich auch kommentrae von instagram hierherholen.
so nutze ich zwar meta/facebook/instagram, aber wenn die mich morgen sperren solten oder ich sie oder meta verendet oder nur noch spanner-brillen verkauft ist mir das egal — weil ich nix verliere.
ich bin kein freund davon zu behaupten sei irgendwas oder gar alles besser gewesen. aber den zustand der isntagram-app, bzw. der instagram-timeline, würde ich schon gerne beklagen. alles ist unübersichtlich geworden, ständig will mir jemand was verkaufen oder mich hypnotisieren und meine aufmerksamkeit absaugen.
wie wohltuend ist da zum beispiel grain: ein vertikaler, scrollbarer sreifen mit fotos, nichts als fotos. und: dark mode, herzchen zum drücken und … fotos. ich schleiche zwar seit wochen durch die ATmosphere, aber auf grain hat mich heute nochmal pxlnv.com gestupst.
weil grain auf dem ATprotokoll basiert und die fotos und metadaten auf meinem, bzw. dem PDS von bluesky speichert, kann ich kirby auch einfach beiträge auf grain posten lassen (indem kirby eingach im richtigen format/schema metadaten und einen blob speichert). auch das geht aus dem kirby-backend per knopfdruck und sieht dann so aus.
warum nicht pixelfed? ich würde sagen weil es meinem verständnis von digitaler unabhängigkeit widerspricht mir ein weiteres social media konto anzulegen nur um einen weiteren ausgabekanal für das zu haben was ich hier auf wirres.net und meiner eigenen fediverse gotosocial instanz schon habe. bei grain hingegegn melde ich mich mit meinem vorhandenen bluesky-konto an und dort, auf dem bluesky PDS wird das auch alles gespeichert und ich kann mit den daten machen was ich will. keine reibung, kein zusätzlicher login, kein zusätzlicher API key, einfach ein weiterer kanal.
weil es so einfach ist bei diensten mitzumachen, die auf dem ATprotokoll aufsetzen, hab ich mir gedacht mal alle profile die ich im lauf der zeit angelegt habe aufzulisten. das ist auch ganz einfach, indem ich in meinen PDS gucke.
ich weiss nicht ob mein verständnis von unabhängigkeit richtig ist oder der reinen lehre entspricht, aber dieses possen fühlt sich gut an. alles zuhause an einem ort zu haben und da wo es geht, da wo es vielleicht wen interessiert, auch meinen quark hinschieben zu können. oder eben auch nicht. wiediewied es mir gefällt.
gestern machte mich der übellaunig ins internet schreibende, aber sehr freundlich in emails schreibende unstory.eu darauf aufmerksam, dass er gelegentlich seiten löscht und jetzt einer meiner links ins leere zeigen würde. das veranlasste mich dazu eine funktion hier nachzurüsten, die nach der veröffentlichung eines beitrags eine warteschlange mit allen links des beitrags füllt und bei archive.org anfragt ob die verlinkten seiten im archive.org gespeichert werden können.
vorher hatte ich mal überlegt ob ich das html von links oder bookmarks einfach bei mir sichern sollte, aber das erschien mir bei näherer betrachtung immer zu komplex und kompliziert.
VW hat die API bei der ich und viele andere ihre fahrzeugdaten abgeholt haben mehr oder weniger gekillt. die begründung ist wohl mehr sicherheit oder so, aber de facto kann ich jetzt weder den ladestand, das odometer, bzw. den status unseres autos nicht mehr in automationen verwenden. auch die navigations- und ladeplanungs app pump, die wir seit einem jahr nutzen, funktioniert damit für uns nicht mehr. sie zeigt den ladestand unseres autos jetzt konstant mit 27% an. die verkackte VW-app funktioniert natürlich weiterhin, was besser als gar nichts ist, aber das ist schon ziemlich arschig von VW so zu agieren.
ein bisschen recherche zeigte, dass es ein paar workarounds gibt, der workaround den ich am interessantesten fand war, dass der stromanbieter tibber offenbar als einer der wenigen „partner“ weiterhin (oder wieder) zugang zu VW-fahrzeugdaten hat. und tibber bietet wiederum einen API zugang zu seinen daten an. die zapfe ich jetzt ersatzweise an und habe jetzt zumindest wieder den ladezustand, die reichweite und die info ob das auto gerade lädt oder nicht im home assistant. damit kann ich wiederum die API von abrp bespielen und wieder mit abrp ladeplanung machen.
seit dem ich viele seiten als markdown anbiete und eine llms.txt anbiete, habe ich das gefühl, dass der druck den KI-crawler auf die website ausüben stark nachgelassen hat. davor kam es immer wieder vor, dass crawler sich durch die archiv-paginierung wühlten und damit den server quälten.
shellies sind wirklich klein. ich habe eine alte ikea-lampe, die eigentlich mit halogen-leuchtmitteln betrieben werden soll auf LEDs umgestellt. dafür musste ein neuer trafo her und damit man die lampe dimmen und schalten kann, habe ich neben dem neuen trafo auch noch einen shelly ins lampengehöuse eingebaut bekommen.


